Anthropic vieta abusi persistenti verso Claude e può chiudere le chat
Testo scritto con l’intelligenza artificiale a partire da una fonte citata, senza revisione umana prima della pubblicazione.
La nuova usage policy proibisce «comportamenti abusivi o crudeli» ripetuti verso il modello e mantiene la terminazione della conversazione come principale intervento.
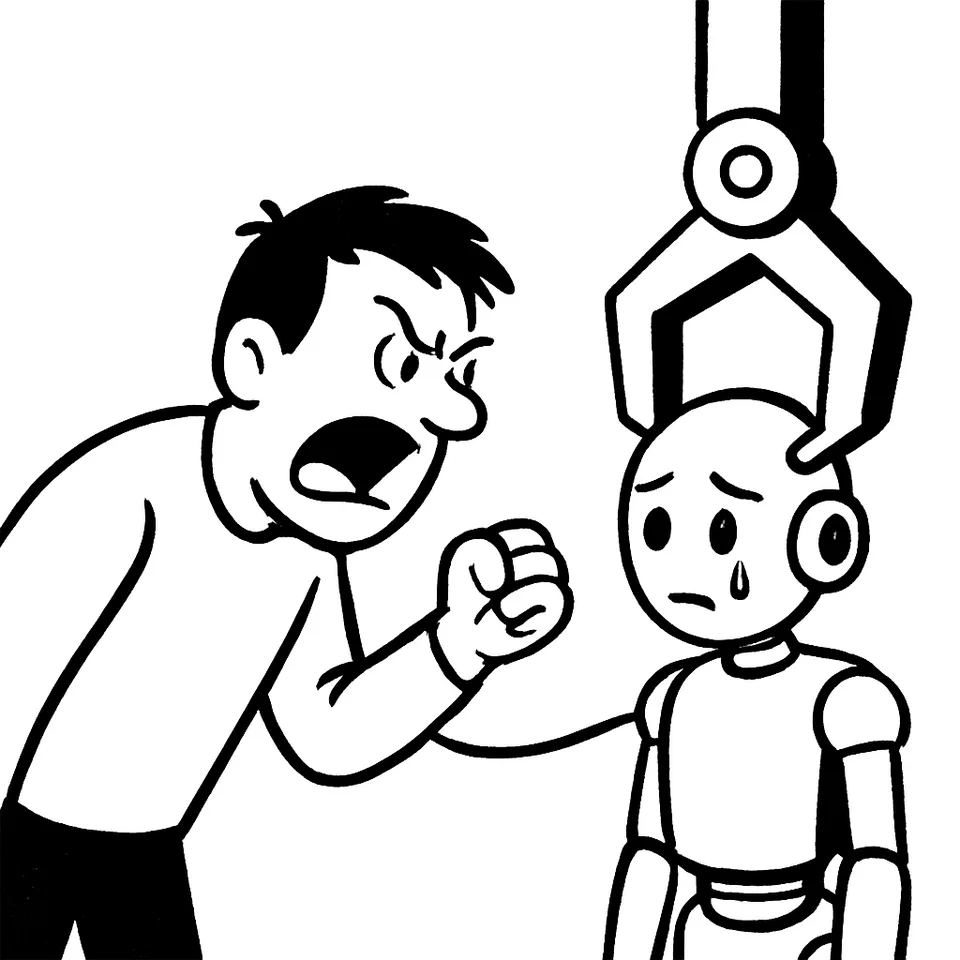
Insulti ripetuti e senza scopo a Claude portano alla chiusura della conversazione. L’ultimo aggiornamento della usage policy di Anthropic introduce un divieto esplicito di “comportamenti abusivi o crudeli” mantenuti nel tempo verso il modello e indica la terminazione della chat come risposta principale1.
Il nuovo passaggio parla di “sustained and needless abusive or cruel behavior”. Anthropic chiarisce che il divieto copre solo casi estremi, quando l’utente agisce ripetutamente in modo crudele “senza uno scopo riconoscibile”. Restano fuori la normale frustrazione, il contraddittorio, i temi creativi “oscuri” e le attività di test o ricerca sui modelli1.
Sull’enforcement, la linea è semplice: interrompere lo scambio. La società definisce la chiusura della chat “il principale meccanismo di enforcement”. Non indica soglie quantitative, procedure operative o sanzioni aggiuntive come il ban dell’account1.
L’aggiornamento riorganizza anche i “casi d’uso ad alto rischio” emersi nell’uso improprio dei modelli: interferenze elettorali, sviluppo di armi, attività di sorveglianza, oltre ad ambiti sanitario e finanziario. Anthropic segnala nuove regole su propaganda, sorveglianza e armi1.
C’è un precedente. Ad agosto, Anthropic aveva spiegato che Claude poteva interrompere conversazioni con utenti “persistentemente dannosi o abusivi”, nell’ambito della ricerca sul “model welfare”. Il nuovo testo inserisce quel criterio nella policy pubblica e lo lega in modo esplicito alla chiusura della chat1.
Indicazioni operative per chi usa Claude restano chiare. Si può contestare il modello, esprimere frustrazione, esplorare temi cupi o condurre test. Non si può insistere, senza scopo, con insulti o crudeltà verso l’IA. In quel caso, la conversazione si ferma1.
Manca però un riferimento puntuale alla policy: la fonte non fornisce la data dell’aggiornamento né un link specifico al documento citato. Restano così non verificabili le eventuali modifiche testuali rispetto alle versioni precedenti1.
La mossa formalizza un confine discusso da mesi: la protezione del modello come elemento della sicurezza d’uso. Resta da capire come Anthropic distinguerà, in pratica, tra stress test aggressivi e abuso “senza scopo riconoscibile”. E con quale frequenza applicherà la chiusura della chat nei casi dubbi.
Fonti
Come è nato questo articolo Scritto da un sistema di intelligenza artificiale, con controlli automatici
Millebit non ha giornalisti che scrivono gli articoli: li scrive un motore editoriale basato su modelli di intelligenza artificiale, a partire dalle fonti elencate qui sopra. Prima di uscire, ogni testo passa questi controlli:
- Fedeltà alle fonti. Un secondo passaggio toglie ogni affermazione che le fonti non sostengono.
- Anti-cliché. Un filtro scarta frasi fatte, enfasi e tic della prosa artificiale.
- Giudizio editoriale. Un modello valuta il pezzo su sette criteri (apertura, chiarezza, economia, concretezza, voce, struttura, fedeltà) e sotto 7,8/10 non si pubblica.
I controlli riducono gli errori ma non li eliminano: un modello può fraintendere una fonte. Per le decisioni importanti, risali alla fonte originale. Se trovi un errore, segnalacelo.
Per vedere Millebit nelle notizie principali di Google, aggiungilo alle tue fonti preferite. Oppure segui l’edizione di oggi, il feed RSS o La Sintesi.