AWS mostra come distribuire un LLM su due nodi GPU
Testo scritto con l’intelligenza artificiale a partire da una fonte citata, senza revisione umana prima della pubblicazione.
Esempio pratico usa nodi separati di prefill e decode dietro un endpoint compatibile OpenAI per superare i limiti di memoria e aumentare il throughput.
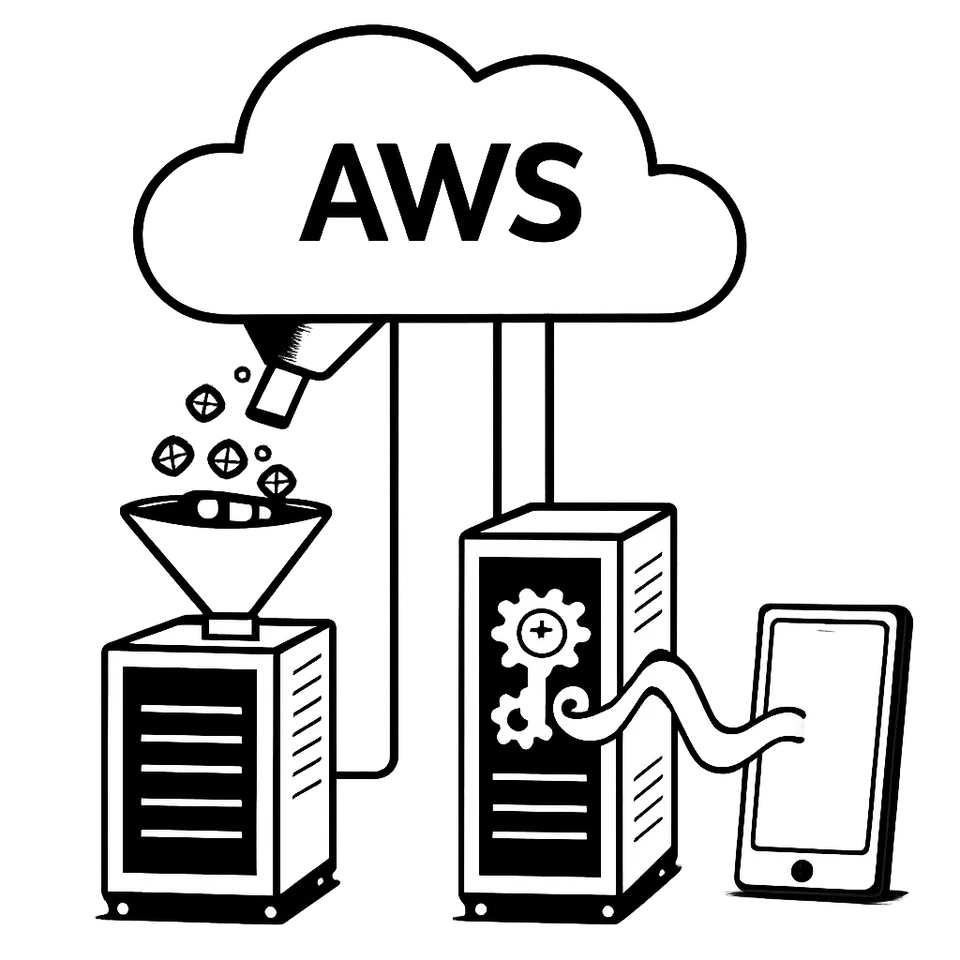
AWS pubblica una guida operativa: un modello linguistico gira su due nodi GPU in Amazon Elastic Kubernetes Service, con prefill e decode separati e un unico endpoint compatibile OpenAI1.
L’esempio parte da Ray Serve e dai Ray LLM Deep Learning Containers. I container fissano una base GPU coerente, includono le librerie necessarie e tolgono di mezzo il codice di contorno. Così il deployment resta ripetibile da un cluster all’altro. Il post precedente mostrava lo stesso stack su un solo nodo, sempre dietro un endpoint HTTP. Qui la stessa architettura scala a più nodi1.
Lo schema è chiaro: due fasi, due nodi. Il prefill occupa un nodo GPU, il decode un altro. Ray Serve coordina il flusso e presenta un endpoint unico, compatibile con le API di OpenAI, che inoltra le chiamate verso i worker corretti. L’attenzione va all’inferenza multi nodo, non al training1.
Ray nasce per il calcolo distribuito. Ray Serve estende un servizio su più nodi senza cambiare il modo in cui il client invia la richiesta. Nella guida, la separazione tra prefill e decode è esplicita. L’obiettivo è sfruttare meglio le risorse e ridurre le code nella fase token per token. Il post collega questa scelta a pratiche note di parallelismo: tensor, pipeline e data parallelism1.
Motivazioni, dette senza giri di parole. Primo, alcuni modelli foundation o open‑weight non entrano in una singola GPU. Secondo, servono più richieste al secondo di quante ne dia una sola replica. Terzo, dividere prefill e decode può migliorare le prestazioni in inferenza. La guida propone Ray Serve in modalità multi nodo come risposta a questi casi1.
I Ray LLM Deep Learning Containers danno stabilità all’ambiente. Stessa immagine su tutti i nodi, stessa toolchain, meno differenze tra host. Questo riduce la variabilità e facilita l’orchestrazione. Il risultato è un deployment che resta coerente nel tempo e tra cluster diversi, sia nel caso a nodo singolo sia nello scenario multi nodo illustrato ora1.
Tutto gira su Amazon EKS. Il cluster ospita due nodi GPU, ognuno con il suo ruolo nell’inferenza. L’endpoint unico espone il servizio verso l’esterno e incapsula la complessità della distribuzione interna. Per il client, la chiamata resta una sola. Per il backend, Ray Serve bilancia e indirizza verso prefill o decode secondo la configurazione descritta nel post1.
Il valore pratico emerge nel perimetro indicato dalla guida. Questa architettura ha senso quando il modello supera la memoria di una GPU, quando il carico richiede più throughput di una replica, o quando conviene isolare le fasi per ridurre la contesa sulle risorse. In questi casi, EKS con Ray Serve e i Ray LLM Deep Learning Containers offre un percorso ripetibile per portare in produzione un endpoint compatibile OpenAI che sfrutta due nodi GPU senza cambiare l’esperienza del caller1.
Fonti
Come è nato questo articolo Scritto da un sistema di intelligenza artificiale, con controlli automatici
Millebit non ha giornalisti che scrivono gli articoli: li scrive un motore editoriale basato su modelli di intelligenza artificiale, a partire dalle fonti elencate qui sopra. Prima di uscire, ogni testo passa questi controlli:
- Fedeltà alle fonti. Un secondo passaggio toglie ogni affermazione che le fonti non sostengono.
- Anti-cliché. Un filtro scarta frasi fatte, enfasi e tic della prosa artificiale.
- Giudizio editoriale. Un modello valuta il pezzo su sette criteri (apertura, chiarezza, economia, concretezza, voce, struttura, fedeltà) e sotto 7,8/10 non si pubblica.
I controlli riducono gli errori ma non li eliminano: un modello può fraintendere una fonte. Per le decisioni importanti, risali alla fonte originale. Se trovi un errore, segnalacelo.
Per vedere Millebit nelle notizie principali di Google, aggiungilo alle tue fonti preferite. Oppure segui l’edizione di oggi, il feed RSS o La Sintesi.