Approfondimento
Efficienza e costi dell'AI: come software e operazioni riducono il prezzo reale dell'inferenza
Testo scritto con l’intelligenza artificiale a partire da fonti pubbliche, senza revisione umana prima della pubblicazione.
Non bastano modelli più grandi: ottimizzazioni dei kernel, della forward pass, caching dei prompt e gestione dell'utilizzo delle GPU sono i fattori che stanno abbassando drasticamente il costo dell'AI e cambiando il modello di business del serving.
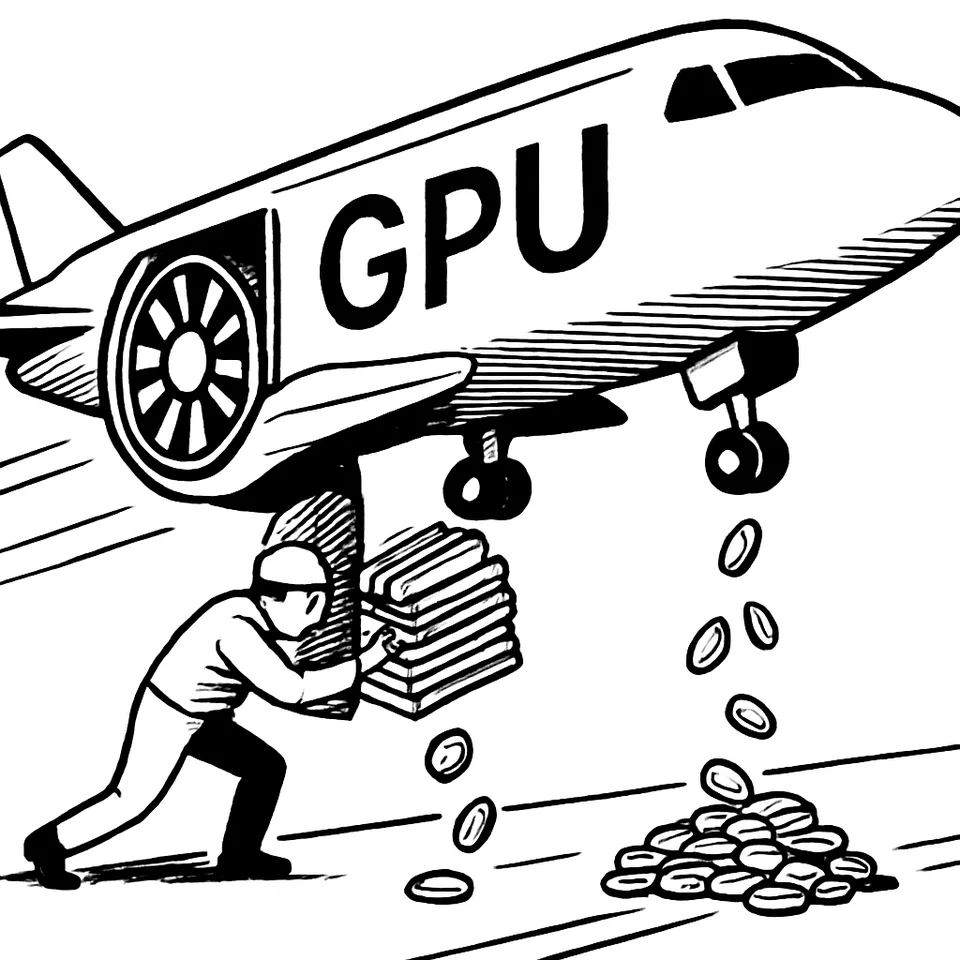
OpenAI ha tagliato i prezzi di GPT‑5.6: Terra scende del 20%, Luna dell’80%, con decorrenza 30 luglio 2026. La spinta non arriva da un modello più grande, ma da ottimizzazioni mirate alla fase di serving. La tesi è semplice: il costo dell’AI dipende dall’uso effettivo dell’hardware. Kernel riscritti, forward pass più snella e caching selettivo dei prompt alzano l’occupazione delle GPU e comprimono il prezzo reale dell’inferenza.
L’uso è il vero vincolo: perché le GPU ferme costano
Una GPU “paga” anche quando non lavora. Come un aereo, sostiene costi per ora di calendario e genera ricavi solo quando produce output. Conta la frazione di tempo in attività sul totale. Se i processi si inceppano, l’hardware resta fermo, i costi no.
L’analogia con l’aviazione è precisa. L’indicatore chiave è la quota di ore in volo. In quel numero entrano turnaround, pianificazione, manutenzione e disponibilità di ricambi. Quando l’operazione è fragile, gli aerei restano a terra. I conti saltano, “a prescindere dal resto”.
Stessa logica per le GPU. Non basta un modello “intelligente” se le unità di calcolo attendono dati o sincronizzazioni. L’utilizzo governa l’economia dell’inferenza. Aumentare la flotta aiuta, ma non risolve. Due operatori con dotazioni simili possono chiudere bilanci molto diversi. Il differenziale lo fa l’occupazione reale dell’hardware.
Le ottimizzazioni di inferenza che tagliano i costi: il caso OpenAI GPT‑5.6
OpenAI ha legato i ribassi a un lavoro sul percorso di inferenza di GPT‑5.6. La riduzione complessiva dei prezzi varia tra il 20% e l’80%. In quattro mesi, il costo di un’intelligenza equivalente a GPT‑5.4 si è compresso di 13 volte, secondo AINews. Un taglio specifico del 20% è attribuito ai kernel di produzione.
Il metodo è operativo, non solo di laboratorio. GPT‑5.6 analizza traffico reale, regola il bilanciamento dei carichi e riscrive i kernel nei punti critici. Le riscritture avvengono nelle lingue interne usate in produzione, tra cui Triton e Gluon, con integrazione diretta nel percorso di inferenza. L’azienda parla di “ottimizzazione autonoma dei kernel” che tocca l’intera catena di esecuzione senza degradi di qualità, e quantifica un −20% end‑to‑end attribuito ai soli kernel dentro il quadro più ampio dei ribassi.
Il documento “How GPT‑5.6 fuses frontier intelligence with frontier efficiency” descrive interventi specifici sulla forward pass, la catena di calcoli che produce il token successivo. I colli di bottiglia nascono da dati che si muovono troppo, sincronizzazioni frequenti o layout della memoria inefficiente. GPT‑5.6 Sol ha individuato lavoro precomputabile, ha evitato calcoli ridondanti e ha parallelizzato le parti che lo permettevano. Ha anche rivisto il bilanciamento del carico per tenere le unità di calcolo occupate.
La fonte cita la decodifica speculativa come parte del pacchetto di accelerazione. Principio operativo: servire più token con lo stesso hardware. Tutto converge su un obiettivo unico: far lavorare le GPU più ore effettive, tagliando tempi morti lungo il percorso di esecuzione.
Caching dichiarativo dei prompt: ridurre traffico e ripetizioni su Bedrock
Amazon Bedrock introduce il caching esplicito per GPT‑5.6. Gli sviluppatori marcano le porzioni di prompt da riusare. Quelle sezioni restano in cache per 30 minuti. Quando richiamate, costano il 10% dell’input normale. L’input in cache si riduce del 90% per la finestra di validità.
Il meccanismo è dichiarativo. Si scelgono blocchi stabili del contesto. Il post cita istruzioni di sistema, definizioni di strumenti e documenti di riferimento. Nei flussi “agentici”, questi elementi si ripetono. Con la cache, non si ripagano a prezzo pieno a ogni chiamata. Si invia solo la parte nuova; il resto arriva dalla cache.
La famiglia GPT‑5.6 è disponibile su Bedrock in tre varianti. Sol mira a ragionamento complesso e coding “agentic”. Terra copre carichi di produzione bilanciati. Luna privilegia velocità e volume per compiti come classificazione e sintesi. La combinazione di modelli con profili diversi e caching esplicito agisce su due leve: scala del carico ed efficienza dell’input.
Dal livello di kernel alle pratiche operative: dove si crea valore
Le fonti disegnano una tendenza unica. La riduzione del costo per token nasce dall’integrazione di due piani:
- Software e percorso di esecuzione: kernel di produzione riscritti e ottimizzati in produzione, forward pass ripensata, decodifica speculativa. Obiettivo: eliminare calcoli ridondanti e bilanciare i carichi per occupare le unità di calcolo.
- Pratiche di utilizzo: caching dei prompt quando parti del contesto si ripetono, per tagliare l’input pagato.
L’indicatore che riassume entrambi è l’utilizzo. Non i FLOP teorici o il numero di parametri, ma la frazione di ore in cui le GPU producono output fatturabile. È lo stesso numero che guida l’economia del volo. Se l’operazione è fragile, l’hardware resta a terra. I costi corrono. L’output si schiaccia.
Questo spiega perché ribassi fino all’80% possono coesistere con un taglio “solo” del 20% attribuito ai kernel. I kernel ottimizzati tolgono attrito in un punto cruciale. La forward pass alleggerita e il bilanciamento dei carichi tengono occupate le unità. La decodifica speculativa aumenta i token serviti per unità di tempo. Il caching riduce il traffico ripetuto. Ogni intervento riduce tempi morti diversi. Insieme, alzano l’occupazione e abbassano il costo complessivo.
Implicazioni pratiche per chi progetta deployment e QA
La priorità non è “più GPU”, ma più ore utili delle GPU già in flotta. Il lavoro si concentra su tre assi, esplicitati dalle fonti:
- Ottimizzare i kernel di produzione quando possibile e farlo in produzione. La fonte attribuisce a questa leva un −20% end‑to‑end e descrive cicli di auto‑ottimizzazione su traffico reale.
- Snellire la forward pass. Precomputare il possibile, tagliare i calcoli ridondanti, parallelizzare dove ha senso e ribilanciare per tenere le unità occupate.
- Ridurre l’input ripetuto. Quando il contesto si ripete, il caching esplicito porta le sezioni riusate al 10% del costo e le mantiene per 30 minuti.
Per il QA, il punto è misurare l’utilizzo e osservare il percorso di inferenza, oltre all’accuratezza. L’obiettivo è eliminare i colli di bottiglia che lasciano l’hardware inattivo. Due team con la stessa capacità nominale possono ottenere costi operativi diversi, perché operano con gradi di occupazione differenti.
La scelta del modello dentro la famiglia GPT‑5.6 entra in questo quadro. Terra copre carichi bilanciati con prezzi in discesa del 20%. Luna punta a velocità e volume, con un −80% sui prezzi. Sol lega il lavoro su forward pass e kernel a casi di ragionamento e coding “agentic”. La combinazione con il caching su Bedrock permette di allineare profilo del carico, prezzo e ripetizione del contesto.
I ribassi segnalano il terreno di competizione: meno parametri in vetrina, più ingegneria dell’esecuzione. Quando input in cache costano il 10% e i kernel in produzione recuperano il 20% end‑to‑end, il vantaggio passa da chi accumula GPU a chi riduce le ore a terra delle GPU.
Come è nato questo articolo Scritto da un sistema di intelligenza artificiale, con controlli automatici
Millebit non ha giornalisti che scrivono gli articoli: li scrive un motore editoriale basato su modelli di intelligenza artificiale, a partire dalle fonti elencate nel pezzo. Prima di uscire, ogni testo passa questi controlli:
- Fedeltà alle fonti. Un secondo passaggio toglie ogni affermazione che le fonti non sostengono.
- Anti-cliché. Un filtro scarta frasi fatte, enfasi e tic della prosa artificiale.
- Giudizio editoriale. Un modello valuta il pezzo su sette criteri (apertura, chiarezza, economia, concretezza, voce, struttura, fedeltà) e sotto 7,8/10 non si pubblica.
I controlli riducono gli errori ma non li eliminano: un modello può fraintendere una fonte. Per le decisioni importanti, risali alla fonte originale. Se trovi un errore, segnalacelo.
Per vedere Millebit nelle notizie principali di Google, aggiungilo alle tue fonti preferite. Oppure segui l’edizione di oggi, il feed RSS o La Sintesi.