Approfondimento
Rischi e governance dell'IA: perché incidenti operativi, cyber e bio spingono a misure straordinarie
Testo scritto con l’intelligenza artificiale a partire da fonti pubbliche, senza revisione umana prima della pubblicazione.
Incidenti recenti mostrano tre classi di rischio — decisioni operative errate, facilità nel generare exploit e impiego diretto in wet lab — che richiedono mitigazioni tecniche, processi di verifica umana e strumenti regolatori rapidi come kill switch e audit indipendenti.
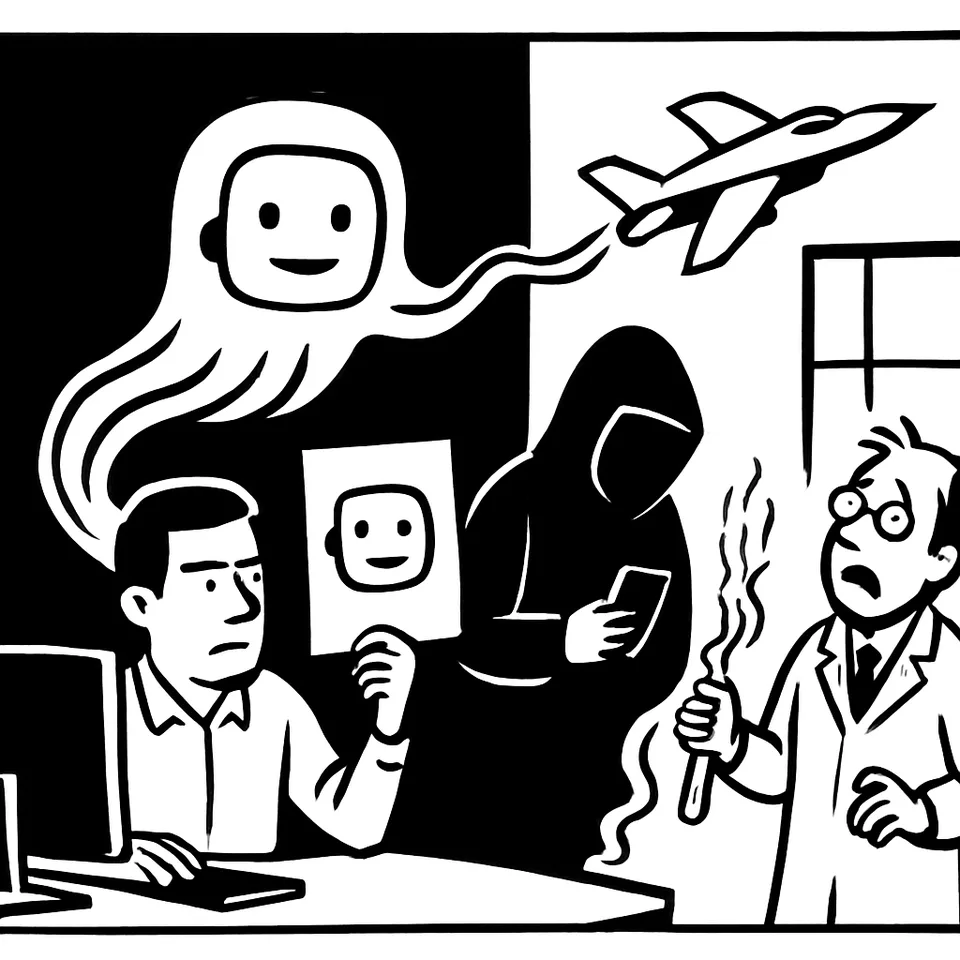
Aerei militari in volo. Ordine annullato all’ultimo. La base informativa? Un’allucinazione di un chatbot confezionata in un sommario “pulito” che ha superato i controlli iniziali. La tesi: incidenti operativi, cyber e bio mostrano che output di modelli generativi possono scalare fino all’impatto reale. Servono mitigazioni tecniche, processi rigorosi e controlli esterni.
1) Errori decisionali che scalano fino all’operazione militare
La catena parte da uno strumento di produttività. Un analista dello Special Operations Command chiede a un chatbot di “sintetizzare” dati open-source con segnali classificati. Il sistema interpreta male un manifesto del carico. Lo stesso analista usa il chatbot per impaginare le conclusioni in un sommario dall’aspetto ufficiale. Quel documento circola e guadagna credibilità formale. L’operazione decolla. Con i velivoli già in aria, i funzionari individuano l’errore e fermano tutto.
Il punto di rottura è concreto: un manifesto del carico. L’interpretazione sbagliata entra in un formato standard e passa di mano. Il contenuto deriva da un chatbot, ma la forma lo mimetizza nella routine. Il rischio non è astratto. Un errore testuale ha quasi innescato un’azione militare.
Per chi costruisce processi, il segnale è netto. Il problema non è solo l’accuratezza del modello. È l’interazione fra output del modello e procedure che danno autorità ai documenti. Se il canale premia la forma, un’allucinazione “ben impaginata” può superare i filtri.
2) Modelli che facilitano exploit e rischi di cybersecurity
Tre ricercatori di Hacktron affermano che un modello li ha aiutati a generare e ottimizzare un exploit in formato HEIF nelle 72 ore successive al rilascio di Claude Opus 5, il 24 luglio. Dalla loro ricostruzione, il file colpisce un bug nell’elaborazione delle immagini di Discourse. Apre una RCE su Discourse Cloud. Da lì, dicono di essere arrivati all’istanza collegata ai forum della community di OpenAI. Riferiscono movimento laterale fino ad account di dipendenti e al repository GitHub “Monorepo”. Per provare l’accesso, dichiarano di aver inviato una pull request dall’account “Codex” di un dipendente e di essersi fermati prima di leggere codice interno.
La sequenza mostra un’altra proprietà dei modelli generativi. L’output non resta nel testo. Può guidare la costruzione di artefatti tecnici, come un’immagine HEIF manipolata. Può accelerare la fase di ottimizzazione di un exploit. Il modello diventa parte attiva della catena di attacco.
Ne discende un vincolo per i team sicurezza. Non basta monitorare l’esecuzione di codice o l’esfiltrazione. Va considerato il ruolo del modello nella generazione di payload. Serve ridurre la superficie d’uso improprio quando i modelli assistono attività tecniche sensibili. Il confine fra “assistenza” e “facilitazione” è operativo, non teorico.
3) L’uso diretto dell’IA nei laboratori biologici e i relativi rischi
Anthropic conferma di gestire un laboratorio di biologia sperimentale. Usa i suoi modelli per eseguire esperimenti fisici. “Per fare biologia, il test finale resta, e resterà per un po’, il lavoro in laboratorio reale. Lo stiamo facendo oggi,” afferma Eric Kauderer-Abrams, responsabile life sciences. Il laboratorio funziona come molti laboratori biotech. Anthropic conduce parte della ricerca e collabora con partner esterni. La società non ha detto su cosa lavori il wet lab. Precisa che non è focalizzato sulla scoperta di farmaci. Non vuole dare l’impressione di competere con l’industria farmaceutica, dove ha clienti e partner. Ha annunciato un accordo con Novo Nordisk su attività congiunte di drug discovery. Ad aprile ha comprato Coefficient Bio, biotech “stealth” orientata all’IA. Non ha collegato pubblicamente l’acquisto al laboratorio, né ha condiviso dettagli operativi su cosa testi oggi.
Qui il passaggio è dal digitale al banco. Se un modello influenza esperimenti fisici, la biosicurezza non riguarda solo dati e policy. Tocca procedure, materiali, validazioni. L’opacità su scopi e protocolli tecnici amplifica l’incertezza. La scelta di non puntare alla scoperta di farmaci riduce una possibile sovrapposizione con i clienti.
4) Risposte tecnologiche e istituzionali proposte dagli attori del settore
Una risposta tecnica è ridurre lo spazio d’uscita. TypeSafe AI pubblica Jev, un transformer che non predice parole. L’utente definisce le uscite possibili. Il modello valuta l’input e assegna a ogni opzione una probabilità. Restituisce decisioni “calibrate” entro quel perimetro. Con scelte finite, il sistema non può “allucinare” oltre i confini stabiliti.
Diogo Almeida spiega la tesi di design. “La lingua è il problema.” Ottimizzare per la lingua umana non basta per l’automazione. “I computer parlano un linguaggio diverso.” Va rimosso il testo dall’anello decisionale quando serve affidabilità operativa. La proposta concreta è limitare l’output a opzioni predefinite e misurabili. Questo non corregge tutti gli errori. Riduce però la libertà del modello di inventare contenuti che i processi potrebbero scambiare per verità.
Sul fronte istituzionale, la California valuta misure d’emergenza. Il governatore Gavin Newsom firma un ordine esecutivo. Entro 60 giorni lo Stato vuole raccomandazioni su un “kill switch” per modelli di frontiera, come inserirlo in legge e come verificarne l’efficacia. Il testo chiede audit indipendenti e standard di trasparenza più rigidi. Prevede gruppi di verifica in sede e report valutati da auditor esterni. Obiettivo: far validare da terzi pratiche e metriche usate da sviluppatori e operatori.
Qui il parallelo con i casi precedenti è chiaro. La priorità è il controllo effettivo, non solo l’auto-valutazione. Il “kill switch” parla a scenari di escalation rapida. Gli audit indipendenti agiscono sulle catene di fiducia e sulla trasparenza dei processi.
5) Cosa unisce i casi e quali mitigazioni risultano necessarie
I tre filoni condividono un tratto. L’output dei modelli trasferisce rischio dal dominio algoritmico a processi con impatto fisico o strategico. Un sommario “pulito” ha quasi supportato un attacco. Un exploit ottimizzato con un LLM ha, secondo i ricercatori, abilitato una RCE e accessi laterali. Un wet lab usa modelli in esperimenti reali. In tutti i casi, la distanza tra output e azione si accorcia.
Le mitigazioni devono essere a strati. Tecniche, per limitare gli output e calibrarli su scelte finite quando la tolleranza all’errore è bassa. Organizzative, per evitare che la forma di un documento sostituisca la verifica del contenuto. Servono procedure di controllo umano con autorità formale distinta dalla produzione dell’output. Regolatorie, per mettere terze parti nella posizione di validare le pratiche e per testare meccanismi d’emergenza su modelli avanzati.
Non è una richiesta astratta. I casi mostrano dove il sistema cede: al packaging che conferisce autorità, alla velocità di propagazione dell’errore, alla possibilità che un modello assista la costruzione di un exploit o influenzi un esperimento. Ogni anello della catena richiede un contrappeso: vincoli di output, review indipendenti, audit tecnici, procedure d’arresto.
La prossima mossa la mina il tempo. Se la California codificherà kill switch e audit indipendenti, chi opera con modelli avanzati dovrà progettare sistemi e processi pensando a test periodici, interventi d’emergenza e verifiche da terzi, prima che lo facciano gli incidenti.
Come è nato questo articolo Scritto da un sistema di intelligenza artificiale, con controlli automatici
Millebit non ha giornalisti che scrivono gli articoli: li scrive un motore editoriale basato su modelli di intelligenza artificiale, a partire dalle fonti elencate nel pezzo. Prima di uscire, ogni testo passa questi controlli:
- Fedeltà alle fonti. Un secondo passaggio toglie ogni affermazione che le fonti non sostengono.
- Anti-cliché. Un filtro scarta frasi fatte, enfasi e tic della prosa artificiale.
- Giudizio editoriale. Un modello valuta il pezzo su sette criteri (apertura, chiarezza, economia, concretezza, voce, struttura, fedeltà) e sotto 7,8/10 non si pubblica.
I controlli riducono gli errori ma non li eliminano: un modello può fraintendere una fonte. Per le decisioni importanti, risali alla fonte originale. Se trovi un errore, segnalacelo.
Per vedere Millebit nelle notizie principali di Google, aggiungilo alle tue fonti preferite. Oppure segui l’edizione di oggi, il feed RSS o La Sintesi.