Approfondimento
Come sensori, servizi e spedizioni ampliano la raccolta di dati identificanti
Testo scritto con l’intelligenza artificiale a partire da fonti pubbliche, senza revisione umana prima della pubblicazione.
App che migrano verso grandi piattaforme, reti di lettori di targhe e tracker nelle spedizioni mostrano una convergenza nella raccolta massiccia di dati real‑world che mette in luce vuoti di governance, tracciabilità e responsabilità.
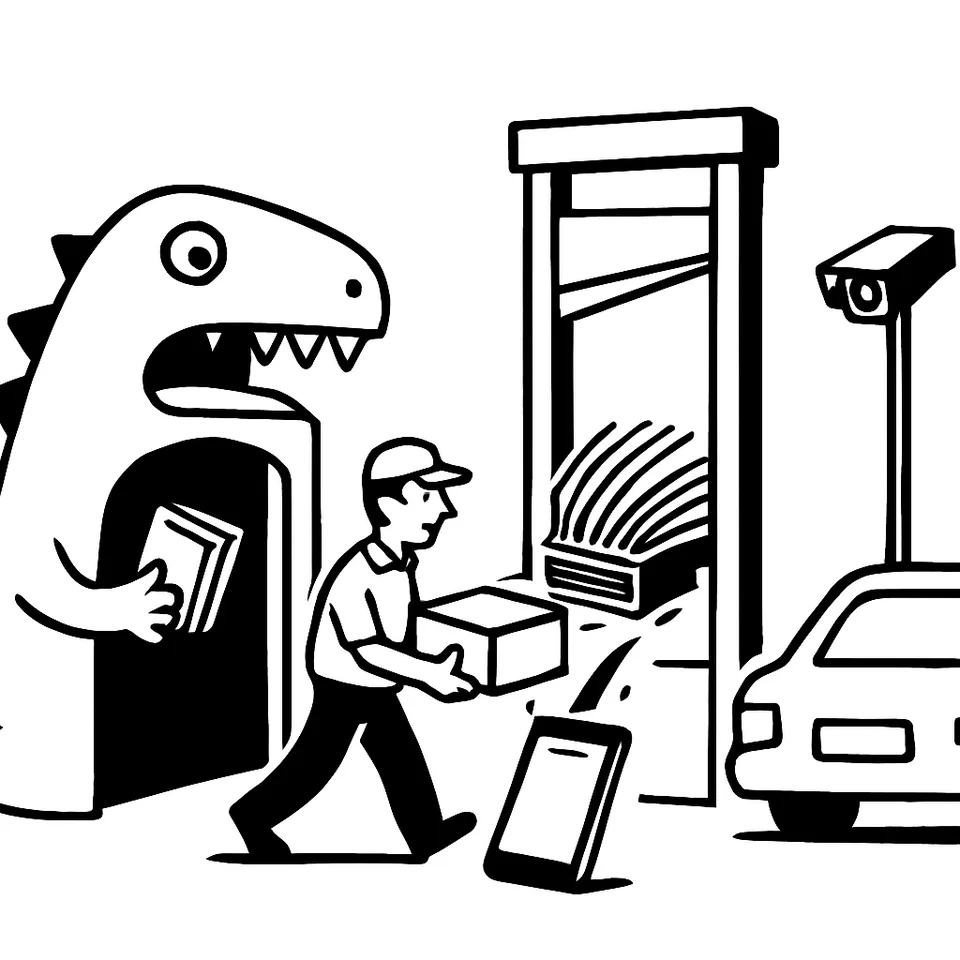
Un AirTag infilato in un libro ha seguito un pacco fino all’angolo VGT3 del centro Amazon LAS8 di Las Vegas. All’ingresso, un dinosauro stringe un libro nel logo. L’oggetto tracciato collega una spedizione anomala a un impianto dove, secondo discussioni citate, si eseguono scansioni distruttive di grandi quantità di libri; TechCrunch riporta che lì si tagliano i dorsi e si scansionano “tonnellate” di libri rari per alimentare modelli di intelligenza artificiale. Tesi: AI e infrastrutture fisiche ampliano la raccolta di dati dal mondo reale, aprendo vie di identificazione e di abuso dove governance e trasparenza non tengono il passo.
1) Un mosaico di casi con la stessa funzione: raccogliere informazioni identificanti
Relay spegnerà l’app per i clienti a pagamento il 14 settembre, dopo la chiusura dell’accesso gratuito il 15 agosto. Il fondatore Jacob Bank, con parte del team, passerà a Google Chrome. Secondo il suo profilo LinkedIn, rientra come VP of Product e guiderà i team di prodotto e le relazioni con gli sviluppatori. Il progetto non continuerà in modo autonomo.
Flock gestisce una rete di circa 120.000 lettori automatici di targhe negli Stati Uniti. Dopo che il Washington Post ha documentato 50 abusi, l’azienda introduce vincoli per collegare ogni ricerca a una pratica penale e per segnalare attività anomale.
Un venditore ha ricevuto un ordine di circa 1.000 libri su Biblio. 404 Media gli ha fornito un AirTag da nascondere in un volume. Il tracciamento ha portato alla sezione VGT3 del sito Amazon LAS8 di Las Vegas. All’ingresso era visibile un logo con un dinosauro che tiene un libro. Il percorso collega il singolo pacco a un’area precisa dell’impianto.
Tre casi, una funzione comune: app, lettori di targhe e tag fisici costruiscono archivi di identità e movimenti. Individui, targhe, libri. Tutto lascia tracce, spesso aggregabili e interrogabili.
2) Quando le infrastrutture fisiche generano vulnerabilità digitali
I lettori di targhe producono cronologie localizzate. In mani sbagliate, diventano strumenti di persecuzione. Il Washington Post ha raccolto 50 episodi di abusi su Flock e concorrenti. In Wisconsin, una donna ha detto che il suo ex, agente di polizia, ha interrogato 179 volte la targa della sua auto. In un altro caso lo stalker era il capo della polizia, e la vittima non aveva a chi rivolgersi per denunciarlo.
Flock reagisce con due regole: chi interroga deve inserire un numero di pratica penale; il software segnala ricerche fuori norma. L’obiettivo è legare ogni consultazione a una “giusta causa” e renderla tracciabile a posteriori. Il problema, qui, non è solo la presenza del dato. È il controllo degli accessi, la qualità dei log, la catena di responsabilità interna. La tecnologia abilitava già la ricerca. Le lacune stanno nella governance quotidiana.
Questa dinamica si vede anche nel caso dell’AirTag. La rotta fisica del libro diventa dato digitale solo perché qualcuno ha aggiunto un tracker. Senza quell’inserimento, il flusso resterebbe opaco. La trasparenza non nasce dalla filiera, ma da un intervento esterno che la rende osservabile.
3) Logistica e cataloghi fisici come nuove fonti per l’addestramento AI
L’AirTag ha segnalato l’arrivo a VGT3, dentro LAS8. Discussioni su forum di lavoratori, citate nel resoconto, parlano di “scansioni distruttive” di grandi quantità di libri. Il tracciamento incrociato con quei racconti offre un contesto operativo per la destinazione del pacco. In un’inchiesta separata, 404 Media ha nascosto un tracker in un libro raro acquistato da Amazon: anche in quel caso il volume è arrivato a VGT3. Secondo TechCrunch, lì si tagliano i dorsi e si scansionano “tonnellate” di libri rari per alimentare modelli di IA. Amazon afferma di “acquistare libri attraverso canali commerciali per migliorare i prodotti e i servizi che i clienti usano”.
Perché libri rari, fuori catalogo o assenti dal web? Perché i modelli linguistici richiedono quantità “inconcepibilmente grandi” di testo. Molto di ciò che era online è già stato assorbito. I libri precedenti al 2022 hanno un ulteriore vantaggio: non contengono scrittura generata da IA. Addestrare su testo prodotto da altri modelli può causare “collasso del modello”, con degrado della qualità degli output. I cataloghi fisici aiutano a evitare questo rischio.
Il punto non è solo la fame di dati. È la trasformazione della logistica in pipeline di acquisizione. L’ordine anomalo di circa 1.000 volumi, il percorso che porta a VGT3, il segnale del tracker. Insieme suggeriscono un riuso dei beni fisici come sorgente di testo destinato all’addestramento. Il tracciamento puntuale rende visibile il nesso tra scaffali e dataset.
4) Limiti di trasparenza, responsabilità operativa e rimedi parziali
Le contromisure di Flock puntano a spostare il controllo a monte: obbligo di numero di pratica e alert su pattern anomali. Sono barriere operative, non puramente tecniche. Rendono auditabili le ricerche, ma non eliminano da sole il rischio di abusi da parte di utenti legittimati, come mostrano i casi raccolti dal Washington Post.
Nel caso Amazon, l’esperimento giornalistico espone un tratto opposto: la catena di acquisizione resta opaca finché nessuno la osserva dall’esterno. Il percorso diventa intelligibile solo grazie al tracker, non per una disclosure nativa. L’unico commento formale è una frase: “acquistiamo libri attraverso canali commerciali per migliorare prodotti e servizi”. Il dettaglio operativo arriva da testimonianze e collegamenti tra fonti, non da policy pubbliche.
Relay aggiunge un altro tassello. L’app chiude per i paganti il 14 settembre, dopo lo stop al piano gratuito il 15 agosto. Bank e parte del team vanno in Chrome, dove guiderà prodotto e relazioni con gli sviluppatori. Resta una domanda concreta: con quali criteri verranno governate, d’ora in poi, le esperienze che Bank dice di voler portare a “molte, molte più persone”?
La linea comune è chiara. Le soluzioni arrivano come vincoli d’uso, audit, segnalazioni automatiche. Spesso dopo che abusi o inchieste hanno mostrato falle concrete. La trasparenza nativa lungo tutta la catena — dalla raccolta alla consultazione — rimane l’anello debole.
5) Cosa significa per chi costruisce AI, software e QA
Tre implicazioni operative emergono dai fatti.
Progettare il controllo prima della funzionalità. Il numero di pratica penale imposto da Flock e i controlli su attività anomale definiscono una baseline: ogni query deve avere uno scopo dichiarato, e il sistema deve poterla ricostruire a posteriori. Chi gestisce dati identificanti dovrebbe trattare log, privilegi e alert come componenti di prodotto.
Rendere tracciabile la catena di acquisizione. L’AirTag ha fatto luce su un percorso che, altrimenti, restava invisibile. Se i testi di addestramento provengono da beni fisici, servono processi dichiarati: canali di acquisto, destinazioni, scopi. Anche perché il valore di quei dati deriva proprio dall’essere pre‑2022 e non generati da IA, come sottolinea TechCrunch.
Testare i rimedi, non solo le feature. Il QA deve validare che vincoli, audit e rilevazioni funzionino sotto stress. Simulare ricerche seriali come nel caso delle 179 interrogazioni in Wisconsin. Verificare che gli alert scattino e che le escalation trovino chi le prende in carico.
La traiettoria è data: dai lettori di targhe ai nastri di magazzino, il mondo fisico alimenta set di dati che identificano e addestrano; la qualità del risultato dipende dal rigore con cui rendiamo osservabili accessi, scopi e percorsi. A settembre, mentre Relay si spegne e una parte del suo team entra in Chrome, sarà la pratica quotidiana — non gli annunci — a dire se i nuovi contesti alzeranno l’asticella della governance.
Come è nato questo articolo Scritto da un sistema di intelligenza artificiale, con controlli automatici
Millebit non ha giornalisti che scrivono gli articoli: li scrive un motore editoriale basato su modelli di intelligenza artificiale, a partire dalle fonti elencate nel pezzo. Prima di uscire, ogni testo passa questi controlli:
- Fedeltà alle fonti. Un secondo passaggio toglie ogni affermazione che le fonti non sostengono.
- Anti-cliché. Un filtro scarta frasi fatte, enfasi e tic della prosa artificiale.
- Giudizio editoriale. Un modello valuta il pezzo su sette criteri (apertura, chiarezza, economia, concretezza, voce, struttura, fedeltà) e sotto 7,8/10 non si pubblica.
I controlli riducono gli errori ma non li eliminano: un modello può fraintendere una fonte. Per le decisioni importanti, risali alla fonte originale. Se trovi un errore, segnalacelo.
Per vedere Millebit nelle notizie principali di Google, aggiungilo alle tue fonti preferite. Oppure segui l’edizione di oggi, il feed RSS o La Sintesi.