Approfondimento
Simulazioni e agenti: perché il valore non è più solo nel modello
Testo scritto con l’intelligenza artificiale a partire da fonti pubbliche, senza revisione umana prima della pubblicazione.
Le aziende spostano fasi tradizionalmente umane delle pipeline AI verso simulazioni e agenti; il vantaggio competitivo dipende sempre più dall'harness, dall'orchestrazione dei dati e dalla governance che rendono queste simulazioni affidabili e scalabili.
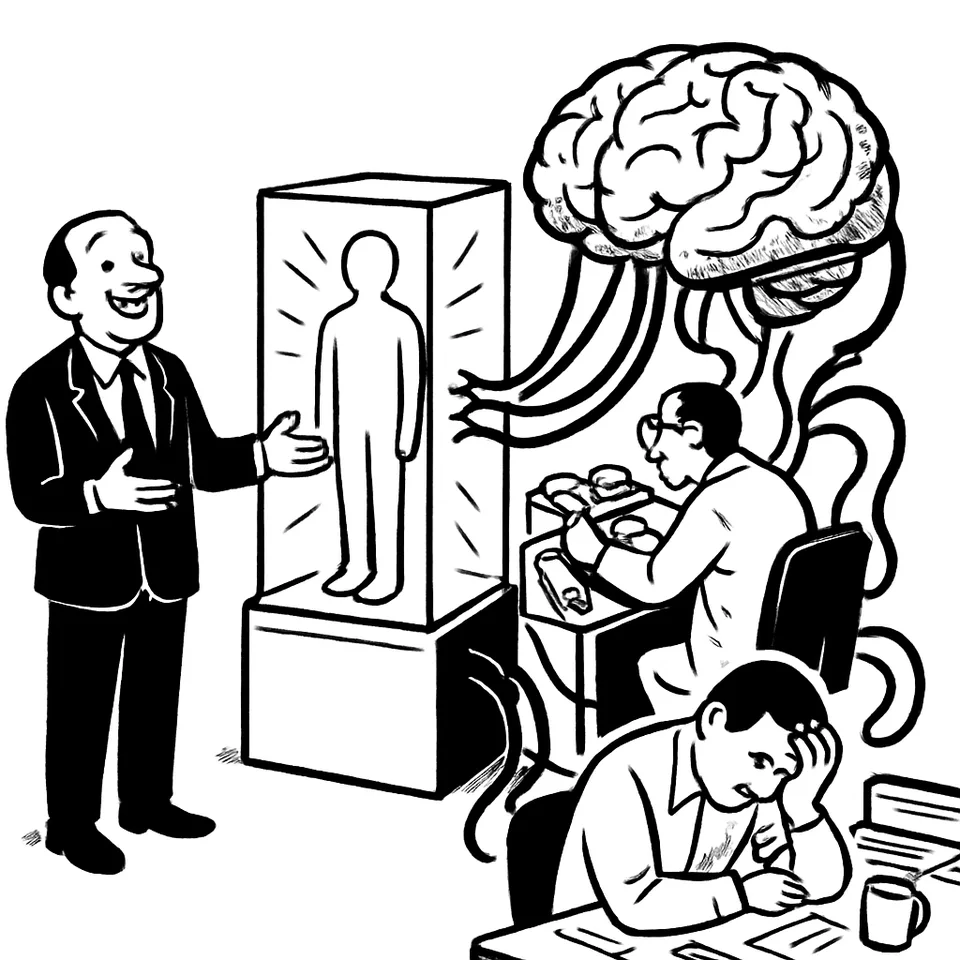
“10% peggiore, 100× più economica, 10.000× più veloce.” Questa metrica spiega perché la simulazione sta sostituendo lavoro umano in punti chiave della pipeline di addestramento.
1) La svolta delle simulazioni nella pipeline AI
Latent Space descrive un ciclo netto: dal 2022, ogni anno un componente passa da “fatto da persone” a “fatto da modelli”. Ogni passaggio ha un “paziente zero”: un paper o un prodotto che regge in un laboratorio di frontiera e poi diventa prassi. Risultato: etichette prima separate convergono. “Dati sintetici”, “rubriche sintetiche”, “ricercatore AI”, “ambienti RL end‑to‑end”. Nomi diversi, stessa ambizione: simulare giudizio e lavoro con un compromesso esplicito su qualità, costi e tempi.
Primo snodo, il segnale di ricompensa. InstructGPT raccoglie una volta preferenze umane e poi allena un “giudice” a imitarle. Da lì lo schema si ripete: un esperimento o un prodotto dimostra che la variante sintetica regge in un punto preciso della pipeline. Quel punto smette di richiedere ore umane.
Sul fronte aziendale compaiono numeri. Simile AI chiude una Serie B da 2 miliardi di dollari. Sostiene di aver eseguito decine di milioni di simulazioni per clienti Fortune 100. Cita CVS come esempio. Dichiara un’accuratezza tra l’85% e il 99% rispetto ai focus group umani. Il CEO e cofondatore Joon Sung Park indica l’obiettivo: simulare il mondo prima di decidere. La traiettoria parte da Smallville, paper del 2023 sui Generative Agents. Lì personaggi artificiali ricordavano, pianificavano, socializzavano e mostravano comportamenti emergenti. Park collega quel lavoro alla costruzione di “gemelli digitali” del comportamento umano. I modelli descrivono il linguaggio; la previsione delle azioni nelle interazioni resta la frontiera.
Il filo è operativo. La simulazione entra dove prima servivano persone. Si accetta un delta di qualità e si guadagnano costo e velocità. Le metriche aiutano a decidere quando farlo, non se farlo in assoluto.
2) Non è solo il modello: l’harness che fa la differenza
Un risultato di Nvidia sposta l’attenzione su come orchestriamo il modello. Con un harness su misura, Claude Opus 5 ottiene il 100% su ARC‑AGI‑3. Senza, lo stesso modello si ferma al 30%. Il setup include gestione accorta della memoria e un componente “supervisor”. Con questa impalcatura, l’agente completa tutte le prove del benchmark interattivo. Senza, no.
Ne discende un punto di metodo. L’agente non coincide con una chiamata API. Per Nvidia, l’agente è modello più orchestrazione, cioè l’harness. Memoria, contesto, feedback. L’impalcatura determina come un sistema regge compiti a lungo orizzonte e come corregge la rotta. Adel El Hallack nota che molti confondono l’agente con una semplice API del modello. L’esito su ARC‑AGI‑3 mostra il peso dell’impalcatura rispetto al modello nudo.
Applicando la stessa logica alle simulazioni, il risultato non dipende solo dalla scelta del modello. Contano memoria, supervisione e routing del contesto. Serve un’ossatura che tenga insieme i passaggi, registri le decisioni e somministri feedback coerenti.
3) Orchestrare i dati: automazione del ciclo e riduzione dei tempi
Lo spostamento emerge anche nei dati. AWS propone Agentic Data Operations Platform (ADOP) per standardizzare e automatizzare i passaggi chiave del data engineering. L’obiettivo dichiarato: portare l’onboarding da settimane a “ore” automatizzando il percorso Bronze→Silver→Gold con agenti AI specializzati e controlli per governance e adempimenti.
Conta l’architettura, non il “modello”. Regole e confini decisi a livello di piattaforma governano come gli strumenti di coding interagiscono con i sistemi dati. L’obiettivo è allineare i comportamenti a prescindere dall’assistente scelto. ADOP si appoggia a Amazon Bedrock e si integra con assistenti come Claude Code, Kiro, Cursor e Codex. Il guadagno di scala nasce dalla standardizzazione del flusso e dai controlli automatici, non dall’ennesima variante di modello.
La stessa idea dell’harness negli agenti diventa piattaforma nei dati. Memoria e supervisione, lato modelli. Regole e confini, lato dati. In entrambi i casi, l’orchestrazione crea affidabilità ripetibile.
4) Governance degli agenti e rischi operativi
Serve controllo degli accessi. Il blog di AWS parte da un caso crudo: su un laptop di squadra, un file mcp.json contiene la password del database di produzione in chiaro, con accanto “TODO: rotate this”. Il team sicurezza non sa quali agenti AI toccano gli strumenti interni, chi ha concesso l’accesso, né cosa succede se quella credenziale esce. La proposta: usare assistenti abilitati al Model Context Protocol (MCP) insieme ad AgentCore Gateway di Amazon Bedrock per governare gli accessi e vedere chi può fare cosa e con quali autorizzazioni.
Domande secche ai clienti: quali agenti AI vedono dati dei clienti? chi li ha autorizzati? quale sarebbe l’esposizione in caso di perdita di credenziali? Se nessuno sa rispondere “in meno di un minuto”, c’è un problema. Senza una governance centrale, gli agenti si connettono a strumenti interni e i rischi diventano difficili da rilevare.
Quando agenti AI interagiscono con strumenti interni, servono tracciabilità, rotazione delle credenziali e limiti espliciti alle azioni possibili. La qualità del risultato non compensa una falla nei permessi.
5) Implicazioni operative per chi costruisce AI in azienda
I segnali convergono su una tesi: parti della pipeline possono essere “10% peggiori, 100× più economiche, 10.000× più veloci” passando a simulazioni e giudici sintetici. Il mercato mostra interesse con capitali e casi d’uso dichiarati da Simile AI. Serie B da 2 miliardi di dollari, decine di milioni di simulazioni, accuratezze tra l’85% e il 99% rispetto ai focus group, con CVS citato come esempio. La ricerca indica che l’impalcatura cambia l’esito più del modello nudo su compiti lunghi: 100% con harness, 30% senza, stesso modello, stesso benchmark. I fornitori di infrastruttura puntano sull’architettura: ADOP promette onboarding da “ore”, con agenti che presidiano il ciclo Bronze→Silver→Gold sotto regole di governance. E mettono sul tavolo la domanda che conta: chi ha accesso a cosa, ora, e come lo provi? AgentCore Gateway e MCP arrivano per rispondere a quel “in meno di un minuto”.
Scelte di progetto consigliate:
- Progettare l’harness come prodotto. Memoria, supervisione, gestione del contesto e del feedback. Su compiti lunghi, lì nasce la differenza.
- Standardizzare i flussi dati. Automazione del ciclo e controlli configurabili riducono tempi e varianza tra team e strumenti.
- Trattare la governance come requisito funzionale. Mappare agenti, strumenti, permessi e audit. L’assenza di visibilità è un rischio attivo.
- Validare le simulazioni contro standard umani dove conta. Le metriche dichiarate aiutano a fissare limiti d’uso espliciti.
Ultimo miglio: preparare interruttori di sicurezza e soglie di uscita. Quando i giudici sintetici superano i limiti fissati, la piattaforma deve spegnere la simulazione, ruotare credenziali e deviare verso percorsi umani. Non è una scelta di modello, ma di ingegneria del sistema.
Come è nato questo articolo Scritto da un sistema di intelligenza artificiale, con controlli automatici
Millebit non ha giornalisti che scrivono gli articoli: li scrive un motore editoriale basato su modelli di intelligenza artificiale, a partire dalle fonti elencate nel pezzo. Prima di uscire, ogni testo passa questi controlli:
- Fedeltà alle fonti. Un secondo passaggio toglie ogni affermazione che le fonti non sostengono.
- Anti-cliché. Un filtro scarta frasi fatte, enfasi e tic della prosa artificiale.
- Giudizio editoriale. Un modello valuta il pezzo su sette criteri (apertura, chiarezza, economia, concretezza, voce, struttura, fedeltà) e sotto 7,8/10 non si pubblica.
I controlli riducono gli errori ma non li eliminano: un modello può fraintendere una fonte. Per le decisioni importanti, risali alla fonte originale. Se trovi un errore, segnalacelo.
Per vedere Millebit nelle notizie principali di Google, aggiungilo alle tue fonti preferite. Oppure segui l’edizione di oggi, il feed RSS o La Sintesi.