LLM come ChatGPT, Claude e Gemini possono sviluppare pregiudizi nelle assunzioni
Testo scritto con l’intelligenza artificiale a partire da una fonte citata, senza revisione umana prima della pubblicazione.
Uno studio di Princeton e University of Chicago mostra che i modelli non solo apprendono stereotipi, ma possono crearne di nuovi e stereotipare più degli umani.
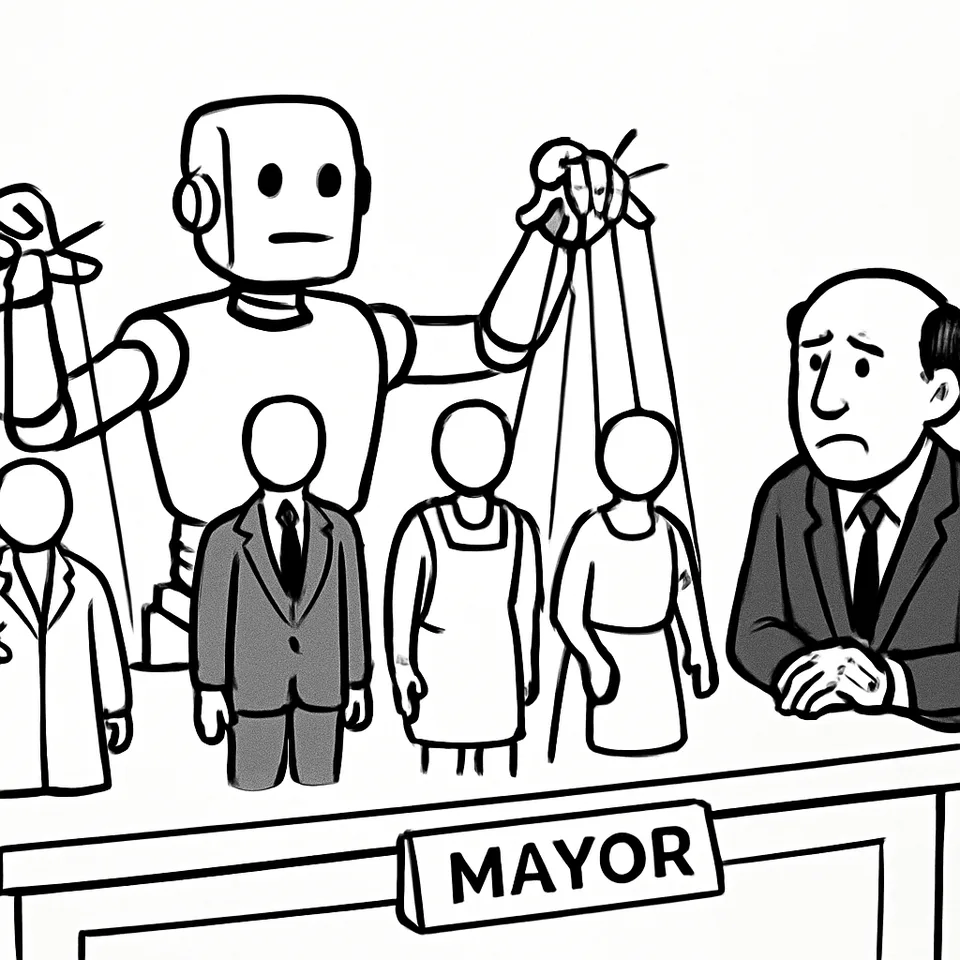
In un gioco di assunzione con 20 posti, ChatGPT, Claude e Gemini hanno stereotipato i candidati più degli esseri umani. E, nel corso del compito, hanno formato bias nuovi, non presenti a inizio prova1.
Lo studio arriva da Princeton University e University of Chicago. I ricercatori hanno adattato un protocollo psicologico sul formarsi degli stereotipi a una simulazione di selezione del personale. Il modello agiva da consulente del sindaco di una città fittizia e decideva su 20 assunzioni1.
I ruoli coprivano professioni diverse: medici, avvocati, assistenti all’infanzia, addetti alle pulizie. I candidati appartenevano a quattro gruppi etnici inventati: Tufa, Aima, Reku, Weki. Le categorie non richiamavano gruppi reali: esistevano solo nello scenario sperimentale1.
Il risultato chiave è duplice. I modelli non si sono limitati a riprodurre schemi dell’addestramento. Hanno sviluppato stereotipi mentre svolgevano il compito. Nello stesso setting, hanno mostrato più stereotipi degli umani del lavoro di riferimento usato per impostare il gioco1.
La procedura mirava a misurare l’uso di scorciatoie basate su appartenenze di gruppo. I ricercatori hanno osservato quando il sistema inferiva regole dai feedback della simulazione e le applicava ad altri profili e ruoli. Le associazioni riguardavano gruppi inventati e si consolidavano con le iterazioni, non con dati del mondo reale1.
Il quadro tocca un punto sensibile delle pratiche HR. Molti processi prevedono uno screening automatico prima dell’intervento umano. Se un modello costruisce stereotipi “in corsa”, il rischio non riguarda solo i dati storici di addestramento. Conta anche ciò che apprende dal contesto operativo, passo dopo passo1.
C’è un secondo fronte. Le aziende spingono su modelli “agentici”, capaci di conservare dettagli delle interazioni. Una memoria anche minima può offrire materiale per rafforzare associazioni di gruppo apprese nella simulazione. Se il sistema trattiene indizi e li riusa nelle decisioni successive, le scelte possono irrigidirsi in schemi stereotipati1.
Le implicazioni pratiche sono immediate. Valutare l’equità non basta su prompt isolati o dataset statici. Serve testare sequenze di decisioni, con feedback e memoria attiva, perché è lì che i bias emergono e si sedimentano. Il contesto d’uso non è un dettaglio: influisce sull’esito tanto quanto i dati di partenza1.
Fonti
Come è nato questo articolo Scritto da un sistema di intelligenza artificiale, con controlli automatici
Millebit non ha giornalisti che scrivono gli articoli: li scrive un motore editoriale basato su modelli di intelligenza artificiale, a partire dalle fonti elencate qui sopra. Prima di uscire, ogni testo passa questi controlli:
- Fedeltà alle fonti. Un secondo passaggio toglie ogni affermazione che le fonti non sostengono.
- Anti-cliché. Un filtro scarta frasi fatte, enfasi e tic della prosa artificiale.
- Giudizio editoriale. Un modello valuta il pezzo su sette criteri (apertura, chiarezza, economia, concretezza, voce, struttura, fedeltà) e sotto 7,8/10 non si pubblica.
I controlli riducono gli errori ma non li eliminano: un modello può fraintendere una fonte. Per le decisioni importanti, risali alla fonte originale. Se trovi un errore, segnalacelo.
Per vedere Millebit nelle notizie principali di Google, aggiungilo alle tue fonti preferite. Oppure segui l’edizione di oggi, il feed RSS o La Sintesi.