SageMaker HyperPod registra IO multi-punto e carica modelli da hub
Testo scritto con l’intelligenza artificiale a partire da una fonte citata, senza revisione umana prima della pubblicazione.
Amazon aggiunge acquisizione dati lungo la pipeline, deploy diretto da hub comunitari, NVMe node-local e integrazione con Route 53 per inferenze enterprise.
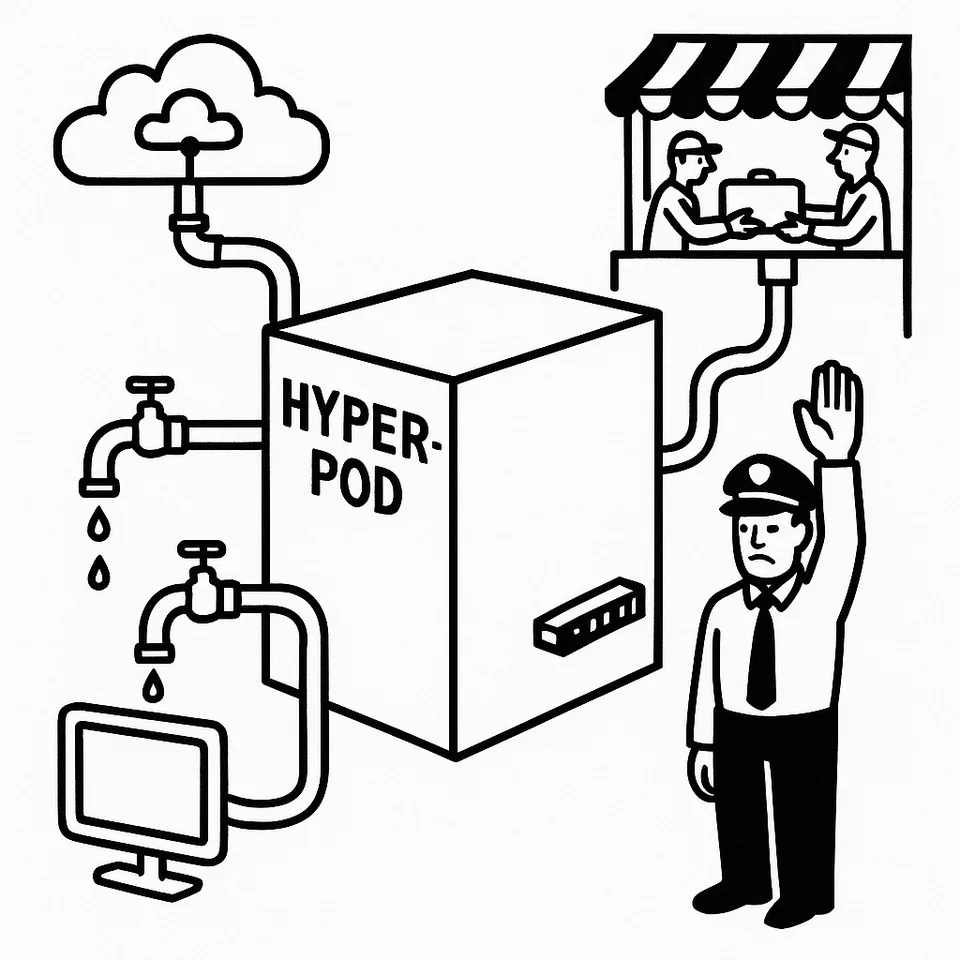
Amazon estende SageMaker HyperPod con tre novità operative: cattura degli input/output su più punti del percorso di inferenza, deploy diretto dei modelli da hub della community senza pre-staging dei pesi e supporto allo storage NVMe locale sui nodi. Arriva anche l’integrazione con Route 53 per la gestione del traffico. La configurazione resta dichiarativa, tramite custom resource definition. Obiettivo: più osservabilità e auditabilità lungo tutta la catena di inferenza1.
La cattura dei dati avviene a livello di endpoint, load balancer e pod che esegue il modello. Ogni tratto del percorso registra ciò che entra e ciò che esce, con una configurazione unica definita in CRD. I team ottengono visibilità granulare, utile per diagnosi, controllo e tracciabilità dei flussi di inferenza1.
Il deploy da hub comunitari è immediato. Non serve copiare prima i pesi su object o file storage. Il flusso include tre garanzie operative: gated access per i modelli che richiedono controlli di accesso, pinning delle revisioni per fissare la versione del modello e isolamento dei token per separare le credenziali d’accesso. Il risultato è una pipeline più corta, con meno passaggi manuali e minori rischi di configurazione1.
Il post cita runtime di inferenza già diffusi: vLLM, TGI e SGLang. Le nuove capacità si collegano a questi ambienti menzionati, facilitando l’adozione su stack esistenti senza dover cambiare il runtime di serving1.
Supporto NVMe locale sui nodi per caricare i pesi. Con i file vicini all’host, il tempo di cold-start si riduce. Il caricamento dalla memoria locale evita hop di rete e limiti di throughput dei backend remoti, con benefici per i primi request di un nuovo replica o pod1.
Integra anche Route 53. La gestione DNS può instradare il traffico verso gli endpoint di inferenza secondo le politiche definite, allineando naming e routing con il resto dell’infrastruttura applicativa1.
La combinazione delle tre leve, cattura multi-punto, deploy diretto da hub, pesi su NVMe locale, punta a semplificare il ciclo di vita dei modelli in produzione. Si riducono i tempi tra scelta del modello e servizio in linea. Aumenta la tracciabilità dei dati che attraversano endpoint, bilanciatore e pod. Si attenua l’impatto del cold-start durante gli scalaggi o i roll-out1.
Per i team che operano su più runtime, il richiamo a vLLM, TGI e SGLang suggerisce un percorso di adozione incrementale. Le nuove funzioni non impongono un cambio di stack, ma offrono punti di integrazione nei contesti citati nel post1.
La disponibilità del deploy diretto da hub, insieme a gated access, pinning e isolamento dei token, può anche standardizzare i processi di approvvigionamento dei modelli. Meno passaggi ad hoc significa meno superfici di errore e un audit trail più lineare, soprattutto quando i flussi devono rispondere a requisiti di controllo e verifica1.
Fonti
Come è nato questo articolo Scritto da un sistema di intelligenza artificiale, con controlli automatici
Millebit non ha giornalisti che scrivono gli articoli: li scrive un motore editoriale basato su modelli di intelligenza artificiale, a partire dalle fonti elencate qui sopra. Prima di uscire, ogni testo passa questi controlli:
- Fedeltà alle fonti. Un secondo passaggio toglie ogni affermazione che le fonti non sostengono.
- Anti-cliché. Un filtro scarta frasi fatte, enfasi e tic della prosa artificiale.
- Giudizio editoriale. Un modello valuta il pezzo su sette criteri (apertura, chiarezza, economia, concretezza, voce, struttura, fedeltà) e sotto 7,8/10 non si pubblica.
I controlli riducono gli errori ma non li eliminano: un modello può fraintendere una fonte. Per le decisioni importanti, risali alla fonte originale. Se trovi un errore, segnalacelo.
Per vedere Millebit nelle notizie principali di Google, aggiungilo alle tue fonti preferite. Oppure segui l’edizione di oggi, il feed RSS o La Sintesi.