I sistemi AI funzionano per molti ma lasciano indietro gruppi specifici
Testo scritto con l’intelligenza artificiale a partire da una fonte citata, senza revisione umana prima della pubblicazione.
Il cosiddetto danno di qualità del servizio rende i sistemi utili solo a una parte degli utenti, con effetti pratici su accesso, tempo e inclusione.
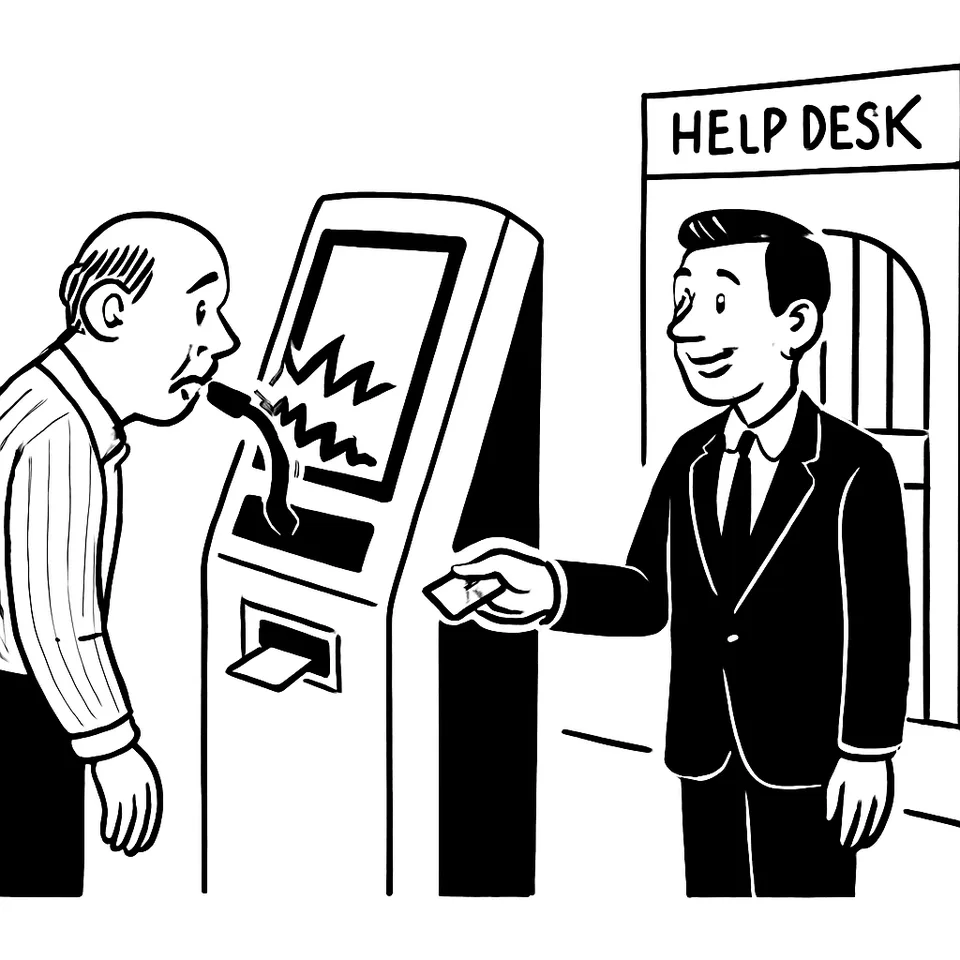
Un assistente vocale capisce subito alcuni utenti e costringe altri a ripetere più volte. È il danno di qualità del servizio: prestazioni diseguali tra gruppi, in base a chi sono le persone e non a cosa chiedono1.
Le metriche medie lo nascondono. Un punteggio complessivo alto può coprire gap netti tra sottogruppi. Gli utenti colpiti spendono più tempo e sforzo per ottenere lo stesso risultato. Si sentono respinti nel punto d’uso. A volte perdono l’accesso al servizio, soprattutto quando l’agente automatizzato è l’unica via disponibile e non esiste possibilità di rinuncia1.
Le differenze seguono linee note: lingua, dialetto, accento; razza, genere, età, disabilità. Il sistema risponde peggio a chi parla con un certo accento, a chi usa una lingua con poche risorse, a chi incontra bisogni di accessibilità. È un rallentamento che scarica il costo sull’utente1.
Nei test questo danno si vede solo se si misura nel modo giusto. Servono valutazioni separate per gruppi diversi, non una media unica. Occorre costruire set di test con accenti, dialetti e lingue vari. Includere nomi differenti e bisogni di accessibilità. Confrontare tassi di errore, percentuali di completamento e sforzo richiesto1.
I dati sintetici non bastano. Le sessioni con persone appartenenti ai gruppi interessati rivelano problemi che i dati sintetici non colgono. Sfumatore di accento, nomi e bisogni di accessibilità possono emergere solo coinvolgendo utenti reali nei test1.
Un riconoscitore vocale sbaglia molto di più con determinati accenti regionali o etnici. Un chatbot risponde bene in inglese, ma male in una lingua a bassa risorsa usata da molti clienti. Utenti cambiano come parlano o scrivono pur di farsi capire da un assistente. In tutti i casi il sistema “funziona”, ma scarica il peso della correzione sull’utente1.
Errori comuni includono la pubblicazione di un solo punteggio di accuratezza, che appiattisce le differenze, e test svolti solo con le voci, gli stili di scrittura e i dispositivi del team, che raramente riflettono l’utenza reale1.
Sul piano legale la copertura è parziale. A volte il danno di qualità del servizio rientra nelle norme anti-discriminazione. Gruppi definiti da classe sociale o livello di istruzione non sono in genere categorie protette. In questi casi può non esistere una via formale di reclamo1.
Quando l’unico canale per un servizio essenziale è un agente automatico, può non esserci modo di rinunciare1.
Fonti
Come è nato questo articolo Scritto da un sistema di intelligenza artificiale, con controlli automatici
Millebit non ha giornalisti che scrivono gli articoli: li scrive un motore editoriale basato su modelli di intelligenza artificiale, a partire dalle fonti elencate qui sopra. Prima di uscire, ogni testo passa questi controlli:
- Rilettura. Un passaggio toglie i tic della prosa generata da un modello, come i contrasti costruiti e le frasi che annunciano invece di informare, senza toccare fatti e fonti.
- Fedeltà alle fonti. Un passaggio dedicato toglie ogni affermazione che le fonti non sostengono. Valutazione su questo pezzo: 10/10.
- Anti-cliché. Un filtro scarta frasi fatte, enfasi e tic della prosa artificiale: superato.
- Giudizio editoriale. Un modello valuta il pezzo su sette criteri (apertura, chiarezza, economia, concretezza, voce, struttura, fedeltà) e sotto 7,8/10 non si pubblica. Questo articolo ha preso 8,2/10.
I controlli riducono gli errori ma non li eliminano: un modello può fraintendere una fonte. Per le decisioni importanti, risali alla fonte originale. Se trovi un errore, segnalacelo.
Per vedere Millebit nelle notizie principali di Google, aggiungilo alle tue fonti preferite. Oppure segui l’edizione di oggi, il feed RSS o La Sintesi.