Stardog costruisce un semantic layer su AWS per agenti generativi
Testo scritto con l’intelligenza artificiale a partire da una fonte citata, senza revisione umana prima della pubblicazione.
La soluzione impiega Amazon Aurora e Redshift e un agente eseguito su Amazon Bedrock AgentCore per rispondere a domande customer 360 senza ETL.
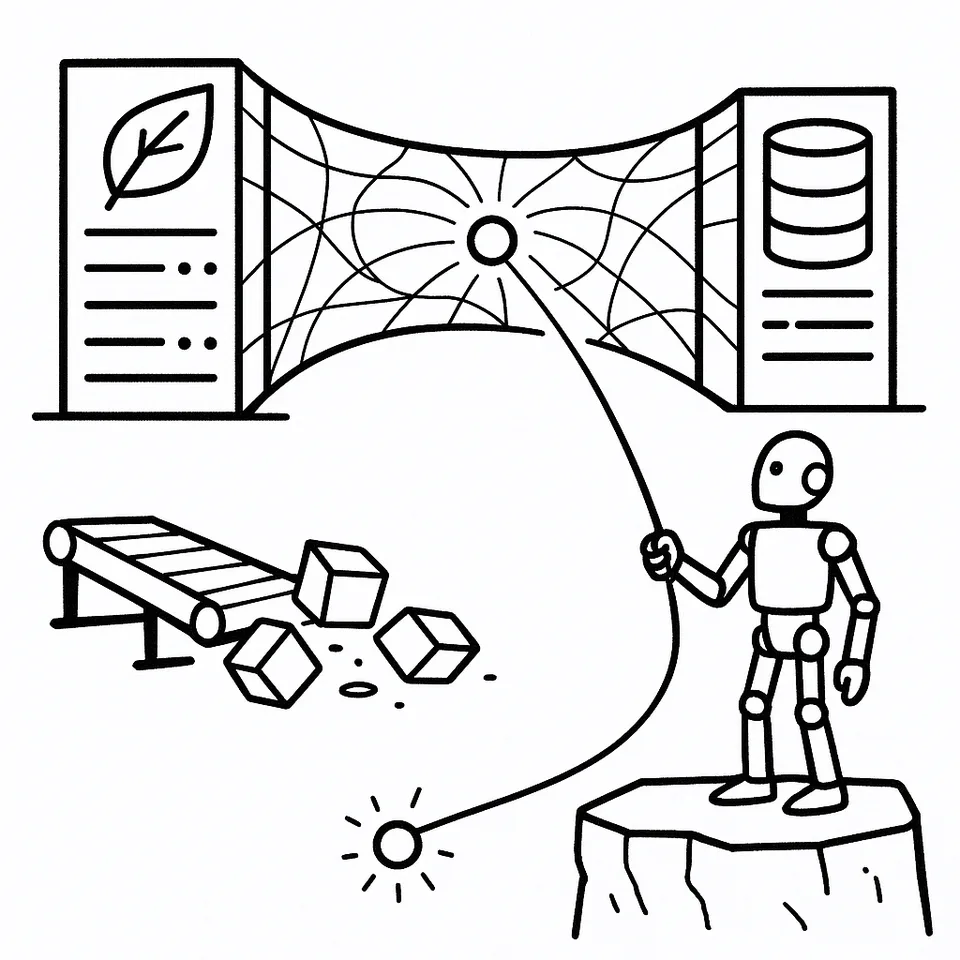
Una richiesta “customer 360” entra in un agente su Amazon Bedrock. L’agente interroga un layer semantico che collega Amazon Aurora e Amazon Redshift. La risposta arriva senza spostare i dati né costruire pipeline ETL1.
Stardog descrive così la propria Semantic AI Application su AWS: un layer semantico sopra Aurora e Redshift, interrogato da un agente (Strands Agents) in esecuzione su Bedrock AgentCore1. L’obiettivo è ridurre i passaggi tra domanda e risposta e unire dati operazionali e analitici dietro un’unica interfaccia per l’agente1.
AgentCore svolge tre compiti operativi in un servizio gestito: autenticazione in ingresso, hosting e gestione delle credenziali degli strumenti. In questo modo l’agente resta nel perimetro gestito mentre si collega alle risorse necessarie. Meno componenti esterni. Meno complessità d’integrazione tra agenti e sorgenti dati1.
Il post elenca tre opzioni di run‑time su AWS per la componente Stardog: Amazon Elastic Kubernetes Service (EKS), Amazon Elastic Container Service (ECS) e AWS Lambda. Cambia l’ambiente di calcolo, non l’architettura logica: il layer su Aurora e Redshift risponde all’agente senza costruire pipeline di estrazione, trasformazione e caricamento1.
Sequenza operativa in tre mosse. L’agente riceve una domanda “customer 360”. Il layer semantico la mappa sui dati in Aurora e Redshift. Restituisce una risposta già composta, mantenendo i dati nelle sorgenti1. Esempio tipico nel post: un’unica catena, dal prompt alla risposta, per analisi che attraversano più sistemi1.
La società inserisce questa scelta nella traiettoria di evoluzione della business intelligence in azienda. Dai report pianificati ai dashboard, poi alla BI self‑service. Nonostante i progressi, molte domande restano fuori dai dataset preparati e richiedono intervento umano. Gli agenti generativi vengono presentati come passo successivo: formulano la domanda e orchestrano gli strumenti per arrivare alla risposta1.
Per Stardog, il fulcro è la semantica condivisa. Il layer descrive dati e relazioni. L’agente usa questa conoscenza per comporre query su più fonti senza una fase preventiva di estrazione e ricarico. La combinazione proposta, Stardog sopra Aurora e Redshift con un agente su Bedrock AgentCore, mostra come implementare su AWS un layer semantico sfruttabile dagli agenti per domande “customer 360”1.
Takeaway operativo: chi già usa Aurora e Redshift può sperimentare l’approccio su AWS scegliendo il run‑time più adatto (EKS, ECS o Lambda), senza cambiare modello semantico o logica dell’agente. Il beneficio dichiarato è una catena più corta tra domanda e risposta, con minore complessità d’integrazione e senza spostare i dati dalle sorgenti1.
Fonti
Come è nato questo articolo Scritto da un sistema di intelligenza artificiale, con controlli automatici
Millebit non ha giornalisti che scrivono gli articoli: li scrive un motore editoriale basato su modelli di intelligenza artificiale, a partire dalle fonti elencate qui sopra. Prima di uscire, ogni testo passa questi controlli:
- Fedeltà alle fonti. Un secondo passaggio toglie ogni affermazione che le fonti non sostengono.
- Anti-cliché. Un filtro scarta frasi fatte, enfasi e tic della prosa artificiale.
- Giudizio editoriale. Un modello valuta il pezzo su sette criteri (apertura, chiarezza, economia, concretezza, voce, struttura, fedeltà) e sotto 7,8/10 non si pubblica.
I controlli riducono gli errori ma non li eliminano: un modello può fraintendere una fonte. Per le decisioni importanti, risali alla fonte originale. Se trovi un errore, segnalacelo.
Per vedere Millebit nelle notizie principali di Google, aggiungilo alle tue fonti preferite. Oppure segui l’edizione di oggi, il feed RSS o La Sintesi.