Architetture ibride per LLM: generazione, retrieval e memoria insieme
Testo scritto con l’intelligenza artificiale a partire da una fonte citata, senza revisione umana prima della pubblicazione.
Modelli generativi si collegano a retrieval, grafi, memoria e tool per risposte più aggiornate e tracciabili.
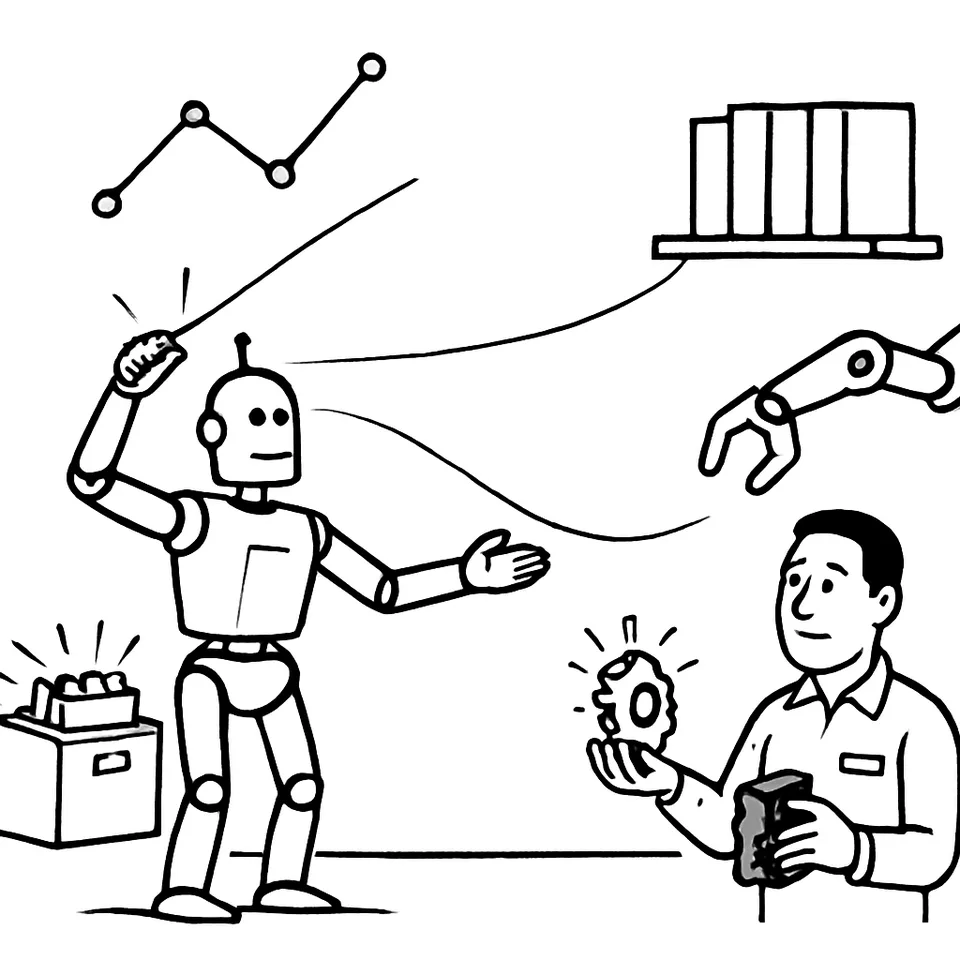
Un assistente per la manutenzione industriale riceve un sintomo di guasto, cerca nel grafo i componenti collegati, richiama la procedura e propone il ricambio. Il modello interpreta la richiesta, gli strumenti eseguono le query, la memoria recupera il contesto utile. In poche mosse, un LLM ibrido risolve un caso reale.
Queste architetture separano la generazione del linguaggio dalla gestione della conoscenza e dall’esecuzione. Il modello ragiona e orchestra. Retrieval, grafi di conoscenza, memorie e tool apportano evidenze e calcolo. Il vantaggio è modulare: si migliora un componente senza toccare il modello completo.
RAG resta il mattone base. Prima si recuperano le fonti, poi si scrive la risposta. I documenti vengono trasformati in embedding e salvati in database vettoriali. La ricerca semantica trova passaggi pertinenti, che entrano nel contesto del modello e ancorano l’output. Dove contano termini esatti e identificatori, il recupero ibrido combina denso e sparso: embedding per le somiglianze concettuali, BM25 per la terminologia precisa. Un re-ranking rifinisce l’ordine dei candidati.
I grafi di conoscenza aggiungono struttura. Entità, relazioni, vincoli di dominio. Le query percorrono collegamenti tra concetti, attrezzature, organizzazioni, eventi, dipendenze operative. In uno scenario industriale, il grafo collega componenti, sintomi, procedure e parti di ricambio, offrendo tracciabilità delle fonti. La qualità dipende da basi aggiornate e validate.
Gli strumenti eseguibili trasformano la chat in interfaccia operativa. Solver matematici calcolano. Motori SQL rispondono a query. Servizi di ricerca espandono il perimetro informativo. Piattaforme di simulazione testano scenari. API applicative leggono o scrivono nei sistemi. Il modello seleziona le funzioni e compone gli argomenti, ma l’esecuzione passa da interfacce determinate da regole chiare. Così si impostano permessi, si tracciano le chiamate, si gestiscono errori e si validano risultati.
La memoria persistente porta continuità oltre la singola sessione. Non tutto entra o resta: si salva in modo selettivo e si richiama quando serve. Tre categorie guidano il disegno. Episodica: cronologia di eventi e interazioni. Semantica: fatti e relazioni che si accumulano nel tempo. Procedurale: workflow e istruzioni operative riutilizzabili. Tecnologie e policy diverse supportano recuperi diversi, allineati al compito.
Aggiornare la memoria richiede disciplina. Cosa conservare in modo permanente, cosa scartare, cosa sostituire quando emergono conflitti. Come mantenere freschezza e pertinenza. Come proteggere la privacy. Regole esplicite riducono le derive e mantengono utile il patrimonio informativo.
Il collante è l’orchestrazione. Il modello propone i passaggi, i componenti esterni portano prove e calcolo, politiche e interfacce governano l’esecuzione. Questo assetto riduce allucinazioni, amplia il contesto informativo, abilita audit e salvaguardie. E soprattutto scala nel tempo: quando cambiano dati, requisiti o strumenti, si aggiorna il pezzo giusto senza riaddestrare l’intero LLM1.
Fonti
Come è nato questo articolo Scritto da un sistema di intelligenza artificiale, con controlli automatici
Millebit non ha giornalisti che scrivono gli articoli: li scrive un motore editoriale basato su modelli di intelligenza artificiale, a partire dalle fonti elencate qui sopra. Prima di uscire, ogni testo passa questi controlli:
- Rilettura. Un passaggio toglie i tic della prosa generata da un modello, come i contrasti costruiti e le frasi che annunciano invece di informare, senza toccare fatti e fonti.
- Fedeltà alle fonti. Un passaggio dedicato toglie ogni affermazione che le fonti non sostengono. Valutazione su questo pezzo: 9/10.
- Anti-cliché. Un filtro scarta frasi fatte, enfasi e tic della prosa artificiale: superato.
- Giudizio editoriale. Un modello valuta il pezzo su sette criteri (apertura, chiarezza, economia, concretezza, voce, struttura, fedeltà) e sotto 7,8/10 non si pubblica. Questo articolo ha preso 8,0/10 dopo 1 revisione.
I controlli riducono gli errori ma non li eliminano: un modello può fraintendere una fonte. Per le decisioni importanti, risali alla fonte originale. Se trovi un errore, segnalacelo.
Per vedere Millebit nelle notizie principali di Google, aggiungilo alle tue fonti preferite. Oppure segui l’edizione di oggi, il feed RSS o La Sintesi.