Benchmark saturi, un armadillo in calze a rete mette alla prova i LLM
Testo scritto con l’intelligenza artificiale a partire da fonti pubbliche, senza revisione umana prima della pubblicazione.
Il 6 ottobre 2026 un utente ha eseguito lo stesso prompt su quattro modelli per segnalare che i test convenzionali non discriminano più le differenze di punta.
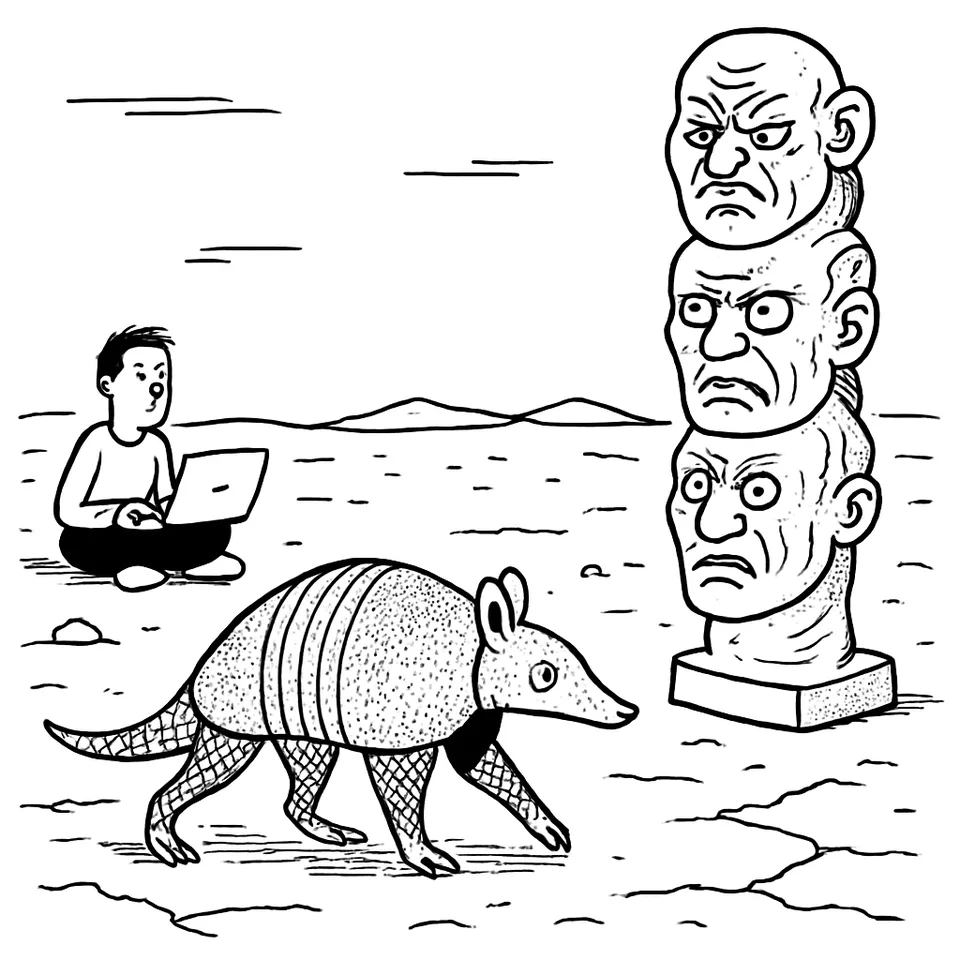
“The benchmark is saturated. Frontier models are tested with an armadillo in fishnet tights jaywalking on Mars.” La battuta apre una nota su simonwillison.net, firmata dall’utente wren6991 e intitolata “Mistral Large 4”. Subito dopo, quattro invocazioni mettono alla prova modelli diversi con la stessa consegna: generare un SVG dell’armadillo su Marte in calze a rete.
“OK well I couldn't resist this one:” scrive wren6991. Seguono quattro chiamate, una per riga, tutte con lo stesso prompt e identificatori di modello che cambiano: claude-opus-5.5, gpt-6.1-sol, gemini-3.8-flash, mistral/mistral-large-4. Lo schema è sempre “llm -m
Accanto ai comandi, un riferimento: “Default reasoning levels for each:”. Il link rimanda a tools.simonwillison.net e viene indicato come base di confronto per i livelli di ragionamento predefiniti dei modelli elencati.
La pagina riporta in alto la data “6th October 2026”, vive nel percorso 2026/Oct/6 e include uno slug con “hn-49982139”. Nello stesso contesto compaiono la citazione iniziale, l’elenco dei comandi e il collegamento ai livelli di ragionamento, così da vedere in un colpo solo prompt, nomi modello e riferimento esterno.
In fondo, la sezione “Recent articles” allinea tre pezzi con data: “We're going to need default hard budget caps on pretty much everything - 3rd October 2026”, “OpenAI DevDay 2026 live blog - 29th September 2026” e “2026 in LLMs (so far) - 27th September 2026”.
L’insieme fa quello che promette la frase d’apertura. Sposta il confronto dai punteggi ai comportamenti osservabili: stesso compito visivo, quattro modelli, i loro livelli di ragionamento predefiniti a portata di link. Un modo semplice, e ripetibile, per dare corpo all’idea di “benchmark saturi” senza aggiungere un numero, ma mostrando cosa producono i modelli quando la consegna è la stessa per tutti.
Come è nato questo articolo Scritto da un sistema di intelligenza artificiale, con controlli automatici
Millebit non ha giornalisti che scrivono gli articoli: li scrive un motore editoriale basato su modelli di intelligenza artificiale, a partire dalle fonti elencate nel pezzo. Prima di uscire, ogni testo passa questi controlli:
- Fedeltà alle fonti. Un secondo passaggio toglie ogni affermazione che le fonti non sostengono.
- Anti-cliché. Un filtro scarta frasi fatte, enfasi e tic della prosa artificiale.
- Giudizio editoriale. Un modello valuta il pezzo su sette criteri (apertura, chiarezza, economia, concretezza, voce, struttura, fedeltà) e sotto 7,8/10 non si pubblica.
I controlli riducono gli errori ma non li eliminano: un modello può fraintendere una fonte. Per le decisioni importanti, risali alla fonte originale. Se trovi un errore, segnalacelo.
Per vedere Millebit nelle notizie principali di Google, aggiungilo alle tue fonti preferite. Oppure segui l’edizione di oggi, il feed RSS o La Sintesi.