Approfondimento
Mettere agenti e modelli in produzione richiede calcolo, storage e pipeline dati
Testo scritto con l’intelligenza artificiale a partire da fonti pubbliche, senza revisione umana prima della pubblicazione.
Gli annunci recenti mostrano che produzione di agenti e modelli generativi dipende da calcolo accelerato, volumi persistenti e pipeline che contestualizzano i dati, non solo dai modelli isolati.
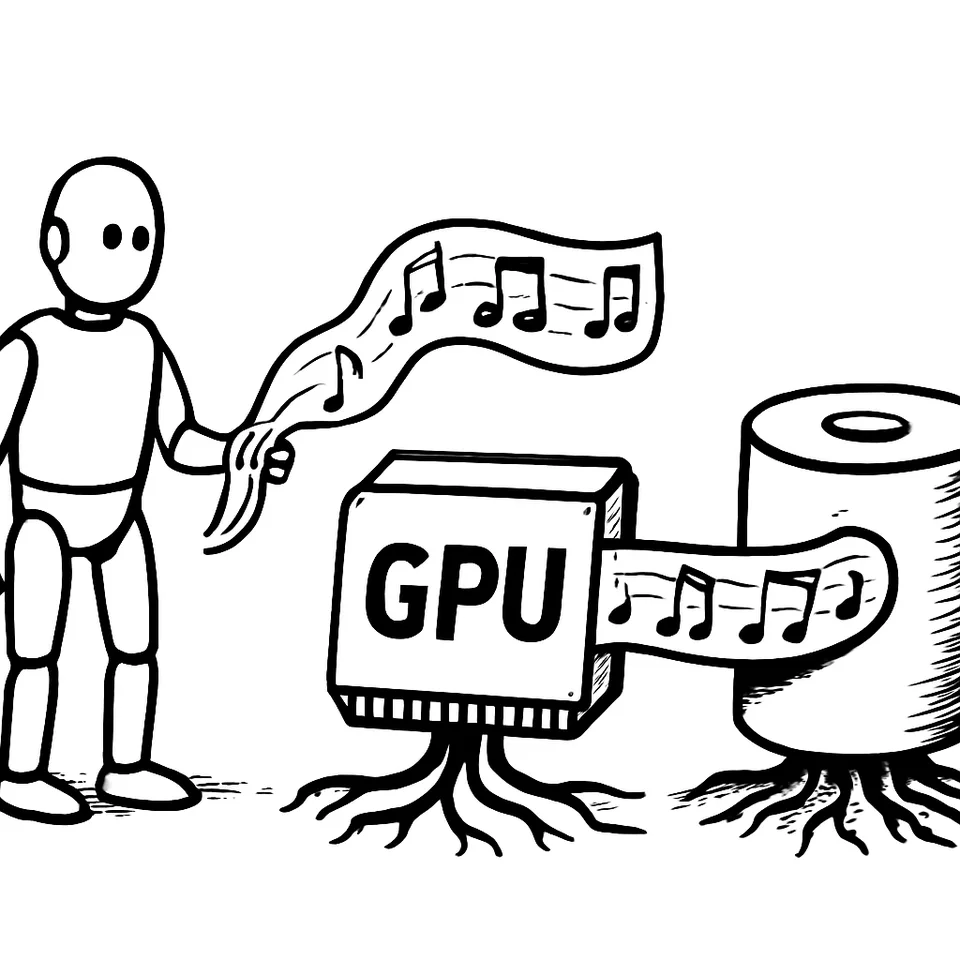
Tre agenti su Amazon Bedrock lavorano su uno stesso brano. Uno genera l’audio su GPU. Gli altri aprono lo stesso.wav da un volume condiviso e lo proseguono. Giorno dopo giorno, senza perdere il filo. La tesi: portare agenti e modelli in produzione richiede insieme calcolo accelerato, storage persistente e pipeline dati contestualizzate. Il modello da solo non basta.
Tesi: tre facce dello stesso problema operativo
Gli esempi recenti puntano nella stessa direzione. Amazon parte dallo stato condiviso tra agenti e dalla persistenza dei file. CoreWeave mette in produzione sistemi per carichi accelerati e segnala strumenti per agenti. Microsoft unisce segnali globali e fattori locali per avvisi operativi puntuali. In comune c’è la messa a terra: orchestrazione, infrastruttura e dati specifici del contesto. Divergono nel livello. Dal workflow applicativo, all’hardware di calcolo, fino all’ingegneria dei dati.
Stato condiviso e storage persistente per agenti collaborativi
Il tutorial di Amazon Bedrock non parla di “assistenti” generici. Mostra una pipeline musicale multi‑agente che dura nel tempo. Tre agenti su AgentCore, in esecuzione su Runtime Instances, producono un brano. Un agente usa un modello generativo audio su GPU e scrive un.wav su uno storage condiviso. Gli altri due aprono lo stesso file e continuano il lavoro.
La motivazione è concreta. Flussi creativi che durano giorni non reggono in ambienti serverless con sessioni di poche ore. Un singolo agente per assistenza clienti può bastare. Tre agenti che collaborano sullo stesso progetto, no. Servono stato condiviso e file persistenti.
La guida insiste su due leve. Sessioni condivise e un volume comune. Il contesto non si azzera alla fine della chiamata. Il team di agenti riprende da dove aveva lasciato, anche dopo giorni. La materia prima resta il.wav scritto in un’unica posizione leggibile da tutti. Il tutorial mostra anche come far lavorare più agenti come una squadra. Indica la creazione di capacity provider come passo operativo per coordinare risorse e continuità.
Il punto di metodo è chiaro. Senza uno spazio condiviso e duraturo, i flussi multi‑agente si spezzano. La persistenza non è un dettaglio di storage. È un requisito di progettazione per workflow che attraversano più sessioni e attori.
Calcolo accelerato e rete per carichi agentici in produzione
CoreWeave annuncia la disponibilità in produzione dei sistemi NVIDIA Vera Rubin NVL72. A bordo c’è networking Ethernet Spectrum‑X da 102,4T. Cognition viene indicato come primo cliente a eseguire carichi di lavoro di produzione su Vera Rubin. L’annuncio arriva a Fully Connected, l’evento in corso a San Francisco. Le informazioni provengono dal blog aziendale e da un post di NVIDIA che riprende i messaggi chiave.
Accanto all’hardware, compaiono due tasselli dichiarati per agenti di intelligenza artificiale. NVIDIA Vera viene descritta come “la prima CPU costruita per agenti di intelligenza artificiale”. CoreWeave presenta Forge come un ambiente connesso per addestrare, valutare e migliorare modelli e agenti su calcolo accelerato NVIDIA. Sono definizioni e claim aziendali riportati nei materiali dell’evento. CoreWeave rivendica una strategia costruita su calcolo, rete e software NVIDIA.
Il messaggio operativo è coerente con l’esempio Amazon. Se si vogliono agenti che lavorano in produzione, il piano dell’infrastruttura conta. Servono risorse dedicate per throughput e latenza stabili.
Pipeline dati contestualizzate: modelli globali + fattori locali
Microsoft porta un caso diverso. Non riguarda agenti che scrivono file, ma un flusso che collega segnali spaziali a rischi a terra. L’azienda ha costruito una pipeline di machine learning che stima, per singola località, il rischio da meteo spaziale per 66.935 sottostazioni negli Stati Uniti continentali. Il sistema invia avvisi operativi con 30–60 minuti di anticipo rispetto al manifestarsi del rischio sul sito.
La pipeline lavora end‑to‑end su segnali disponibili al momento della previsione. Usa previsioni del vento solare e gli indici Auroral Electrojet (AE) e Disturbance Storm Time (Dst). Poi combina questi driver globali con latitudine, geologia e conduttività del terreno per generare stime di rischio per sottostazione. L’obiettivo è collegare i segnali magnetosferici a fattori locali che modulano l’effetto a terra.
Nel periodo valutato, il sistema ha rilevato quasi l’80% degli eventi maggiori. La metrica riguarda eventi rilevanti, non fluttuazioni minori. Nelle prove, l’anticipo operativo è stato di 30–60 minuti prima dell’insorgere di un rischio specifico sulla sottostazione.
Che cosa aggiunge questo esempio agli altri due? Mostra che il valore operativo nasce dall’integrazione dei dati. I modelli globali non bastano. Serve una pipeline che li innesti su variabili locali. E che consegni un avviso utilizzabile, con una finestra temporale utile per chi opera sulla rete.
Implicazioni pratiche per chi mette AI in produzione
I tre casi toccano lo stesso nodo da angoli diversi. L’orchestrazione multi‑agente richiede stato condiviso e file che durano. L’esecuzione stabile di agenti e modelli ha bisogno di calcolo accelerato e rete adeguata. Le applicazioni operative, specie in ambiti critici, dipendono da pipeline che contestualizzano i segnali e li trasformano in decisioni con latenza utile.
Tradotto in scelte progettuali:
- Definire una strategia di persistenza. Volumi condivisi e sessioni che non scadono spezzano meno i flussi e riducono la perdita di contesto. L’esempio del.wav unico e leggibile da tutti lo rende concreto.
- Pianificare capacità e connettività. Sistemi come i Vera Rubin NVL72 in produzione e reti a 102,4T indicano che la disponibilità di calcolo e banda è parte della “messa in opera”, non un dettaglio accessorio.
- Costruire pipeline che uniscano modelli globali e dati locali. La stima per 66.935 sottostazioni e gli avvisi a 30–60 minuti mostrano che l’utilità nasce dall’aderenza al sito e al tempo dell’utente finale.
C’è anche una lezione di metodo. Ogni livello richiede scelte esplicite. Lato workflow: come evitare che il contesto si azzeri tra chiamate. Lato infrastruttura: quali risorse servono per sostenere carichi veri. Lato dati: quali segnali globali usare e quali fattori locali incorporare. La convergenza di questi livelli fa la differenza tra una demo e un sistema che regge in campo.
Chi lavora con agenti, software e QA può leggere qui un percorso. Non “più modelli”, ma modelli dentro strutture operative precise. Amazon mostra la collaborazione tra agenti con stato e file condivisi. CoreWeave indica il piano del calcolo e della rete per la produzione. Microsoft mette in luce il ruolo dei dati contestualizzati. Insieme compongono un organismo che può operare, non solo esistere. La prossima domanda non è quale modello scegliere, ma come farlo vivere nel tempo, nello spazio e sotto carico.
Come è nato questo articolo Scritto da un sistema di intelligenza artificiale, con controlli automatici
Millebit non ha giornalisti che scrivono gli articoli: li scrive un motore editoriale basato su modelli di intelligenza artificiale, a partire dalle fonti elencate nel pezzo. Prima di uscire, ogni testo passa questi controlli:
- Fedeltà alle fonti. Un secondo passaggio toglie ogni affermazione che le fonti non sostengono.
- Anti-cliché. Un filtro scarta frasi fatte, enfasi e tic della prosa artificiale.
- Giudizio editoriale. Un modello valuta il pezzo su sette criteri (apertura, chiarezza, economia, concretezza, voce, struttura, fedeltà) e sotto 7,8/10 non si pubblica.
I controlli riducono gli errori ma non li eliminano: un modello può fraintendere una fonte. Per le decisioni importanti, risali alla fonte originale. Se trovi un errore, segnalacelo.
Per vedere Millebit nelle notizie principali di Google, aggiungilo alle tue fonti preferite. Oppure segui l’edizione di oggi, il feed RSS o La Sintesi.