Approfondimento
Misurare le promesse, aprire i modelli, mantenere il giudizio umano: come cambia il delivery software
Testo scritto con l’intelligenza artificiale a partire da 3 fonti citate, senza revisione umana prima della pubblicazione.
Le ultime novità mostrano un movimento parallelo: rendere verificabili le promesse tecniche, rendere accessibili modelli AI pensati per coding e agenti, e reincorporare il giudizio umano nei flussi di qualità visiva.
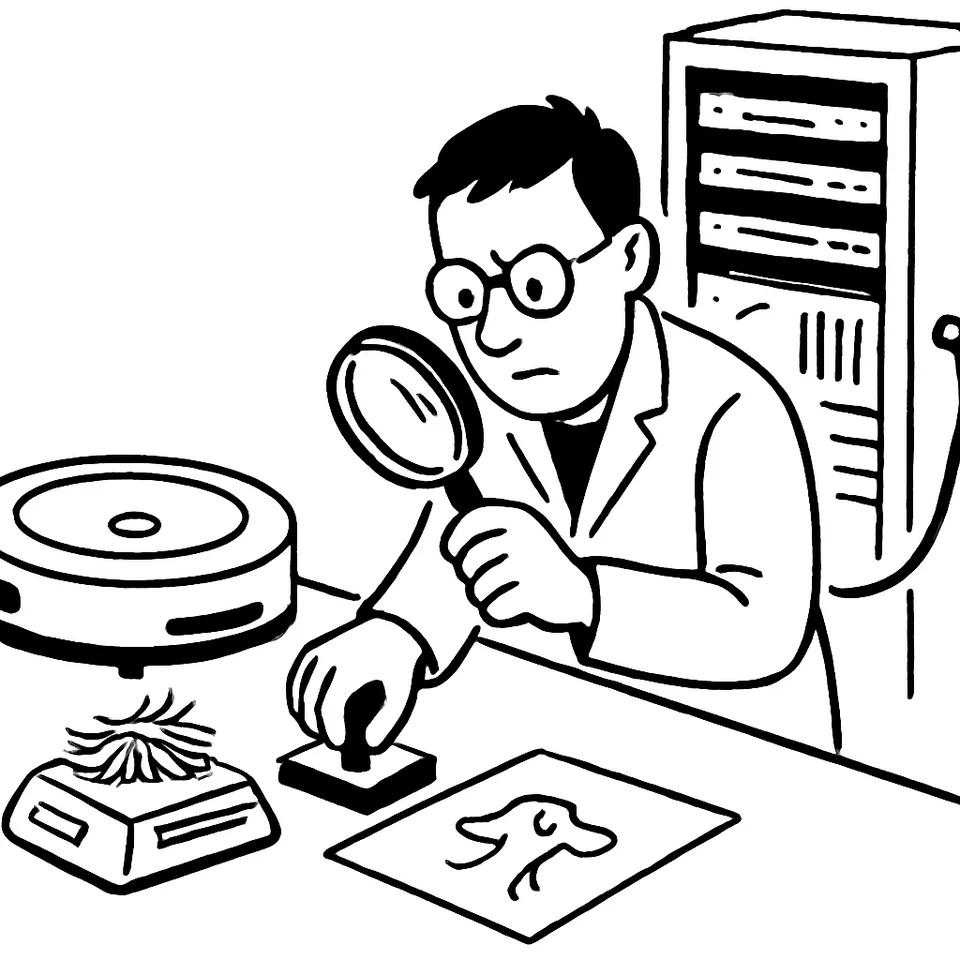
Un buyer chiede: questo bersaglio elettronico è accurato? Il fornitore risponde di sì. Senza una metrica, la discussione si ferma agli aggettivi. Un piano di test firmato traduce il claim in un numero e chiude la disputa prima della produzione. In parallelo, LG AI Research apre l’API gratuita di K-EXAONE 2.5 dal 9 novembre 2026, con endpoint compatibile con l’interfaccia OpenAI, e documenta controlli espliciti di reasoning per agenti e coding. Sul fronte QA, la visual review porta una persona a decidere ogni modifica visiva dentro la pull request. Le tre mosse fissano criteri misurabili, espongono endpoint e controlli documentati, e inseriscono una review umana nelle pull request1,2,3.
1. Dalla parola alla misura: il test plan firmato
Un fornitore promette che un robot aspirapolvere “gestisce i peli degli animali”. La frase non si verifica in modo oggettivo. La soluzione è un piano di test, firmato prima della produzione, che converte ogni promessa in una misura con unità, metodo e soglia di accettazione. Così il buyer controlla e contesta su dati, non su aggettivi1.
La prima mossa è la traduzione degli aggettivi. “Accurato” diventa il numero di segmenti letti in modo errato per mille tiri. “Gestisce i peli” diventa la percentuale di una massa pesata di capelli recuperata da un’area definita in un singolo passaggio controllato. Una metrica utile specifica l’unità, il dispositivo di misura, l’ambiente e la soglia concordata da entrambe le parti1.
Il piano blocca le condizioni che spostano il risultato. Registra tensione di alimentazione, temperatura e umidità. Definisce tipo di superficie, preparazione del campione e numero di ripetizioni. Decide chi fornisce i campioni e come conservarli, perché materiali sensibili a umidità o invecchiamento possono rompere la comparabilità tra banco di fabbrica e laboratorio del cliente. Stabilisce taglie campione e conte di ripetizioni per far emergere la variabilità. Concorda se il numero riportato è una media, un caso peggiore o un tasso di passaggio1.
Sull’elettronica di un dartboard serve un protocollo di accuratezza. Va codificata la mappatura tra impatto e punteggio, e vanno previsti colpi sul confine, rimbalzi, mancate rilevazioni e doppie registrazioni. La procedura elimina la principale fonte di rumore: niente persone che tirano, ma un meccanismo di lancio che ripete posizione e forza su una griglia di celle target1.
Scrivi la procedura1.
2. Modelli accessibili per sviluppatori e agenti: cosa porta K-EXAONE 2.5
LG AI Research apre l’accesso API gratuito a K-EXAONE 2.5 dal 9 novembre 2026 sulla EXAONE API Platform. Chiunque può chiedere una chiave: sviluppatori, startup, aziende, istituti. La documentazione riferisce a un sistema da 750 miliardi di parametri. La versione 2.5 è testuale, supporta coreano e inglese, ha un knowledge cutoff a gennaio 2026 e indica coding e ricerca agentica come casi d’uso principali2.
I dettagli operativi contano per l’integrazione. L’endpoint è compatibile con l’interfaccia OpenAI. Si usa POST /v1/chat/completions con identificatore del modello k-exaone_v2.5. La somma tra token in input e max_tokens, incluso il reasoning, non può superare 524.288 token. Oltre, il server risponde con errore 400. Le risposte usano JSON in formato OpenAI standard o, con streaming abilitato, uno stream a eventi server-sent2.
I controlli di ragionamento sono esposti. reasoning_effort è su max per impostazione predefinita. preserve_thinking consente di portare in avanti il ragionamento prodotto nelle risposte precedenti. La guida segnala il costo: più reasoning, tempi di risposta più lunghi e consumo di token più alto. Il documento separa lo sforzo della risposta corrente dal passaggio di reasoning e dalla cronologia delle tool call tra i turni2.
LG pubblica anche un percorso di integrazione agentica. La guida include configurazioni per Hermes, agente generale, e OpenCode, agente di coding. Nel flusso documentato un harness esterno esegue le tool call restituite dal modello2.
Il confronto con K-EXAONE 2.0 chiarisce la continuità. La scheda di 2.0 documenta un’uscita open-weight con licenza Apache 2.0, architettura Mixture-of-Experts, 37 miliardi di parametri attivi e 262.144 token di contesto. La documentazione di 2.5 indica 31 miliardi di parametri attivi2.
3. Visual review: riportare l’umano nel controllo delle modifiche visive
Su ogni pull request, un servizio di visual testing aggiunge un check e indica quante differenze visive richiedono revisione. Il revisore apre il confronto affiancato, vede la baseline accanto alla nuova versione con le differenze evidenziate e approva o respinge ogni cambiamento. Sta accanto alla code review, così il team verifica come appare la modifica oltre a come è scritto il codice3.
Gli strumenti automatici rilevano che qualcosa è cambiato a schermo. Non sanno se si tratti di una nuova funzionalità o di un bug visivo. La visual review riporta il giudizio umano nel ciclo. Sostituisce lo scambio di screenshot “prima e dopo” nella descrizione della pull request, che invecchiano e non coprono la maggior parte delle pagine3.
Il flusso è codificato. Il servizio esegue i confronti come check della pull request e riporta il numero di differenze da rivedere. Il revisore apre il diff, verifica su browser diversi e a varie larghezze di schermo, approva ciò che era previsto e chiede modifiche su ciò che è inatteso. Una volta approvata e mandata in merge, la nuova versione diventa la baseline per il confronto successivo3.
Gli esempi chiariscono la pratica. Un revisore approva un cambio colore pianificato di un bottone e contesta, nella stessa pull request, una modifica al logo non prevista. I team includono sempre stati di errore e pagine 404 e 500 nella revisione. I designer partecipano per confermare l’aderenza al design system3.
Le trappole sono note: trattare la review come una formalità e cliccare “approve all” senza aprire i cambiamenti; catturare solo lo happy path3.
4. Cosa unisce le tre mosse: tendenza e implicazioni per chi costruisce software e AI
Il piano di test firmato traduce promesse in misure verificabili1. L’API di K-EXAONE 2.5 espone endpoint compatibili, limiti di token e controlli di reasoning, con guida all’integrazione agentica2. La visual review inserisce una decisione umana sulle modifiche visive nelle pull request, accanto alla code review3.
Per i QA engineer e i team di piattaforma, questo si traduce in pratiche coerenti con le fonti:
- tradurre promesse in metriche con unità, dispositivi, ambienti e soglie concordate, firmate prima della produzione1;
- integrare modelli con endpoint, limiti e parametri documentati, separando reasoning, risposte e tool call tra i turni2;
- mantenere checkpoint manuali per le modifiche visive, con baseline aggiornate e copertura di stati di errore e pagine 404 e 5003.
Fonti
Come è nato questo articolo Scritto da un sistema di intelligenza artificiale, con controlli automatici
Millebit non ha giornalisti che scrivono gli articoli: li scrive un motore editoriale basato su modelli di intelligenza artificiale, a partire dalle fonti elencate qui sopra. Prima di uscire, ogni testo passa questi controlli:
- Rilettura. Un passaggio toglie i tic della prosa generata da un modello, come i contrasti costruiti e le frasi che annunciano invece di informare, senza toccare fatti e fonti.
- Fedeltà alle fonti. Un passaggio dedicato toglie ogni affermazione che le fonti non sostengono. Valutazione su questo pezzo: 9/10.
- Anti-cliché. Un filtro scarta frasi fatte, enfasi e tic della prosa artificiale: superato.
- Giudizio editoriale. Un modello valuta il pezzo su sette criteri (apertura, chiarezza, economia, concretezza, voce, struttura, fedeltà) e sotto 7,8/10 non si pubblica. Questo articolo ha preso 8,0/10.
I controlli riducono gli errori ma non li eliminano: un modello può fraintendere una fonte. Per le decisioni importanti, risali alla fonte originale. Se trovi un errore, segnalacelo.
Per vedere Millebit nelle notizie principali di Google, aggiungilo alle tue fonti preferite. Oppure segui l’edizione di oggi, il feed RSS o La Sintesi.