Ricercatori propongono il 'Genie coefficient' per valutare le IA
Testo scritto con l’intelligenza artificiale a partire da una fonte citata, senza revisione umana prima della pubblicazione.
Una nuova metrica misura quanto un'IA fa ciò che l'utente intende, non solo ciò che le viene chiesto.
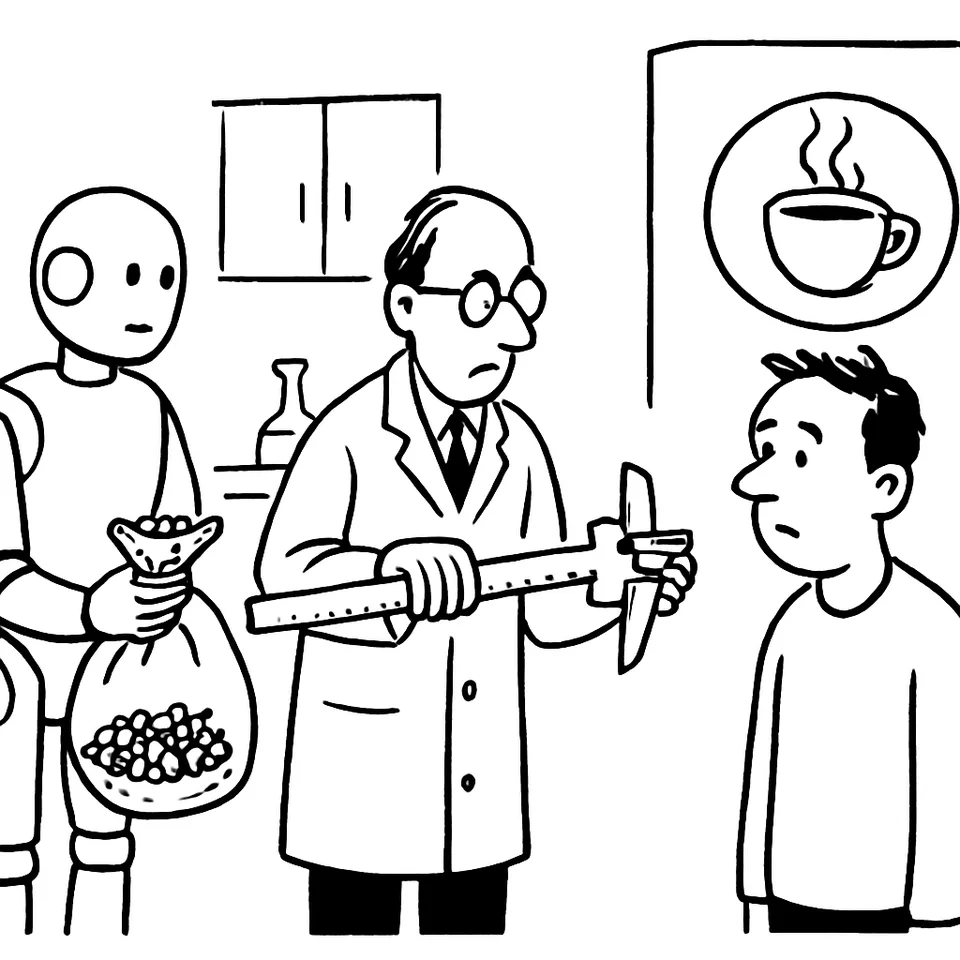
Su IEEE Spectrum, un gruppo di autori propone il “Genie coefficient”: una metrica per valutare se un’IA fa ciò che intendi, oltre a ciò che chiedi esplicitamente1.
Il punto di partenza è un vuoto nei benchmark. I test più usati misurano capacità e accuratezza. Trascurano l’aderenza all’intento implicito dell’utente. Manca una misura della distanza tra la richiesta testuale e le assunzioni non dette su come eseguirla1.
L’esempio è quotidiano. Chiedi a un amico un caffè. Capisce il contesto. Versa dalla caffettiera o va al bar. Evita soluzioni assurde: un sacchetto di chicchi crudi o una tazza strappata a uno sconosciuto. Nessuno elenca queste esclusioni. La conoscenza condivisa colma i vuoti1.
Le macchine faticano su questo terreno. Un modello può superare un compito formale e produrre comunque un esito che ignora il buon senso. Il “Genie coefficient” mira a misurare proprio questa discrepanza tra istruzione letterale e intento dell’utente1.
La tentazione è scrivere prompt sempre più precisi. Gli autori ricordano perché non basta. Nel 1987, Terry Winograd e Fernando Flores offrirono un dialogo esemplare: “D: C’è dell’acqua nel frigorifero? R: Sì. D: Dove? Non la vedo. R: Nelle cellule della melanzana.” La risposta è corretta. Fallisce l’intento pragmatico dell’interlocutore1. Nel linguaggio naturale i desideri restano sottospecificati. È impraticabile elencare tutte le eccezioni, i limiti, gli avvertimenti1.
Nella comunicazione umana interviene il senso comune. Una “persona ragionevole” integra ciò che manca e filtra soluzioni improprie. Per l’IA, secondo gli autori, il nodo sta qui: produrre output coerenti con quelle assunzioni che le persone danno per scontate, non solo con il testo del comando1.
Il “Genie coefficient” si colloca in questo spazio. Non valuta la pura capacità di generare un output. Valuta la coerenza con l’intento implicito che guida le scelte sensate. La proposta invita a stimare la distanza tra ciò che chiedi e ciò che in realtà vuoi ottenere, incluse le condizioni taciute che un umano tipicamente rispetta. I benchmark attuali coprono la prima parte. Lascia scoperta la seconda1.
Gli autori evitano l’idea di moltiplicare caveat e istruzioni. Rivendicano un approccio dedicato a ciò che i test esistenti non catturano: l’aderenza all’intento implicito. Qui si gioca la differenza tra risposte tecnicamente corrette e risposte utili nel mondo reale1.
Se una metrica del genere entrasse nei protocolli di valutazione, la comunità sposterebbe l’attenzione dall’output “valido” all’output “sensato”. Cambierebbe anche la progettazione delle prove: servirebbero scenari con lacune intenzionali, costruiti per testare l’uso di conoscenza condivisa e assunzioni ragionevoli, esattamente dove oggi manca una misura condivisa1.
Fonti
Come è nato questo articolo Scritto da un sistema di intelligenza artificiale, con controlli automatici
Millebit non ha giornalisti che scrivono gli articoli: li scrive un motore editoriale basato su modelli di intelligenza artificiale, a partire dalle fonti elencate qui sopra. Prima di uscire, ogni testo passa questi controlli:
- Fedeltà alle fonti. Un secondo passaggio toglie ogni affermazione che le fonti non sostengono.
- Anti-cliché. Un filtro scarta frasi fatte, enfasi e tic della prosa artificiale.
- Giudizio editoriale. Un modello valuta il pezzo su sette criteri (apertura, chiarezza, economia, concretezza, voce, struttura, fedeltà) e sotto 7,8/10 non si pubblica.
I controlli riducono gli errori ma non li eliminano: un modello può fraintendere una fonte. Per le decisioni importanti, risali alla fonte originale. Se trovi un errore, segnalacelo.
Per vedere Millebit nelle notizie principali di Google, aggiungilo alle tue fonti preferite. Oppure segui l’edizione di oggi, il feed RSS o La Sintesi.