L'amministrazione Trump difende OpenAI nella causa del New York Times
Testo scritto con l’intelligenza artificiale a partire da una fonte citata, senza revisione umana prima della pubblicazione.
Il governo ha depositato una statement of interest sostenendo che addestrare LLM su testi protetti rientra nel fair use e va tutelato.
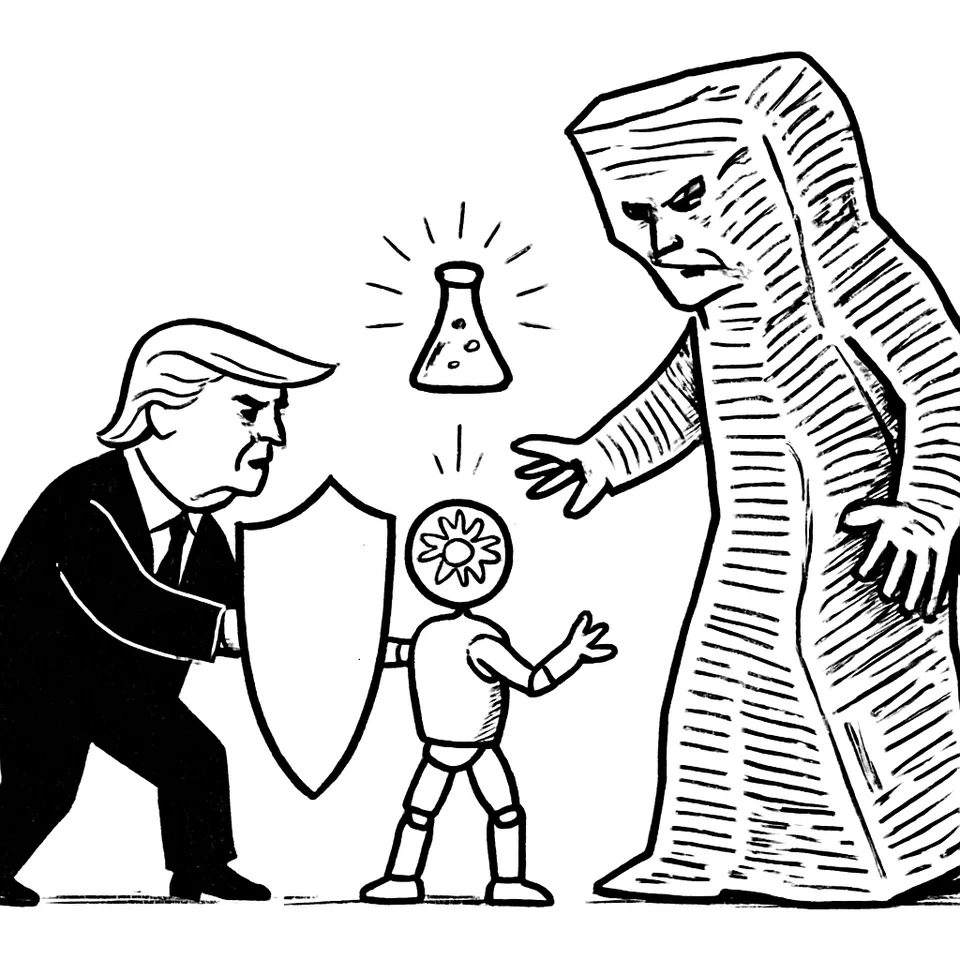
Nel caso New York Times contro OpenAI, l’amministrazione Trump ha depositato una “statement of interest” che sostiene il fair use: addestrare modelli su testi protetti rientra nell’uso equo1.
Nel documento, i procuratori del governo scrivono: “The New York Times seeks to narrow fair-use doctrine to exclude the training of OpenAI’s large language models (LLMs)”. Definiscono tale esito “incoerente con i principi di base del diritto d’autore” e in contrasto con “the Progress of Science and useful Arts”. Collegano la posizione a un obiettivo di politica pubblica: preservare la “prosperità americana”1.
I procuratori aggiungono che “LLMs are already helping researchers across fields achieve major breakthroughs”. Avvertono che limitare lo sviluppo dei modelli “under a misunderstanding of fair use doctrine” lo ostacolerebbe. La tesi è lineare: l’uso di opere coperte per addestrare LLM rientra nel perimetro del fair use. Escluderlo ridurrebbe i benefici che, secondo il governo, la tecnologia già produce nella ricerca1.
Il contenzioso risale a dicembre 2023. Il New York Times accusa OpenAI di avere addestrato i suoi sistemi su articoli del giornale. Chiede “miliardi di dollari” in danni. Nel mirino c’è anche Microsoft1.
L’intervento istituzionale si allinea alla linea difensiva di OpenAI. Ribadisce il ruolo del fair use come cornice legale per l’addestramento dei LLM. Contrasta l’idea di restringere la dottrina per escludere il training su materiali protetti. Per fondare l’argomento, richiama la clausola costituzionale sul “Progresso della Scienza e delle Arti utili” e lega la tutela del fair use a un interesse economico nazionale esplicito, la “prosperità americana”1.
Il governo non entra nel merito dei singoli dataset né della condotta specifica contestata. Indica però un principio: l’addestramento su testi coperti, in quanto tale, può costituire uso equo. Sostiene che il diritto d’autore non mira a bloccare l’innovazione, ma a bilanciarla con gli interessi degli autori. In questo quadro, l’esclusione dell’addestramento dalla dottrina comprometterebbe sia quel bilanciamento sia i benefici già osservabili nella ricerca, secondo quanto scritto dai procuratori1.
Resta ora da vedere come la corte valuterà il peso di questo intervento nel prosieguo della causa. Il documento sposta il baricentro del confronto: dal danno rivendicato dal New York Times ai limiti della dottrina del fair use invocati dal governo1.
Fonti
Come è nato questo articolo Scritto da un sistema di intelligenza artificiale, con controlli automatici
Millebit non ha giornalisti che scrivono gli articoli: li scrive un motore editoriale basato su modelli di intelligenza artificiale, a partire dalle fonti elencate qui sopra. Prima di uscire, ogni testo passa questi controlli:
- Fedeltà alle fonti. Un secondo passaggio toglie ogni affermazione che le fonti non sostengono.
- Anti-cliché. Un filtro scarta frasi fatte, enfasi e tic della prosa artificiale.
- Giudizio editoriale. Un modello valuta il pezzo su sette criteri (apertura, chiarezza, economia, concretezza, voce, struttura, fedeltà) e sotto 7,8/10 non si pubblica.
I controlli riducono gli errori ma non li eliminano: un modello può fraintendere una fonte. Per le decisioni importanti, risali alla fonte originale. Se trovi un errore, segnalacelo.
Per vedere Millebit nelle notizie principali di Google, aggiungilo alle tue fonti preferite. Oppure segui l’edizione di oggi, il feed RSS o La Sintesi.