DeepMind lancia EmbeddingGemma 2, embedding multimodale da 740M per l'on‑device
Testo scritto con l’intelligenza artificiale a partire da una fonte citata, senza revisione umana prima della pubblicazione.
Modello aperto Apache 2.0 che unifica testo, codice, immagini, video e audio per ricerca e RAG direttamente sui dispositivi.
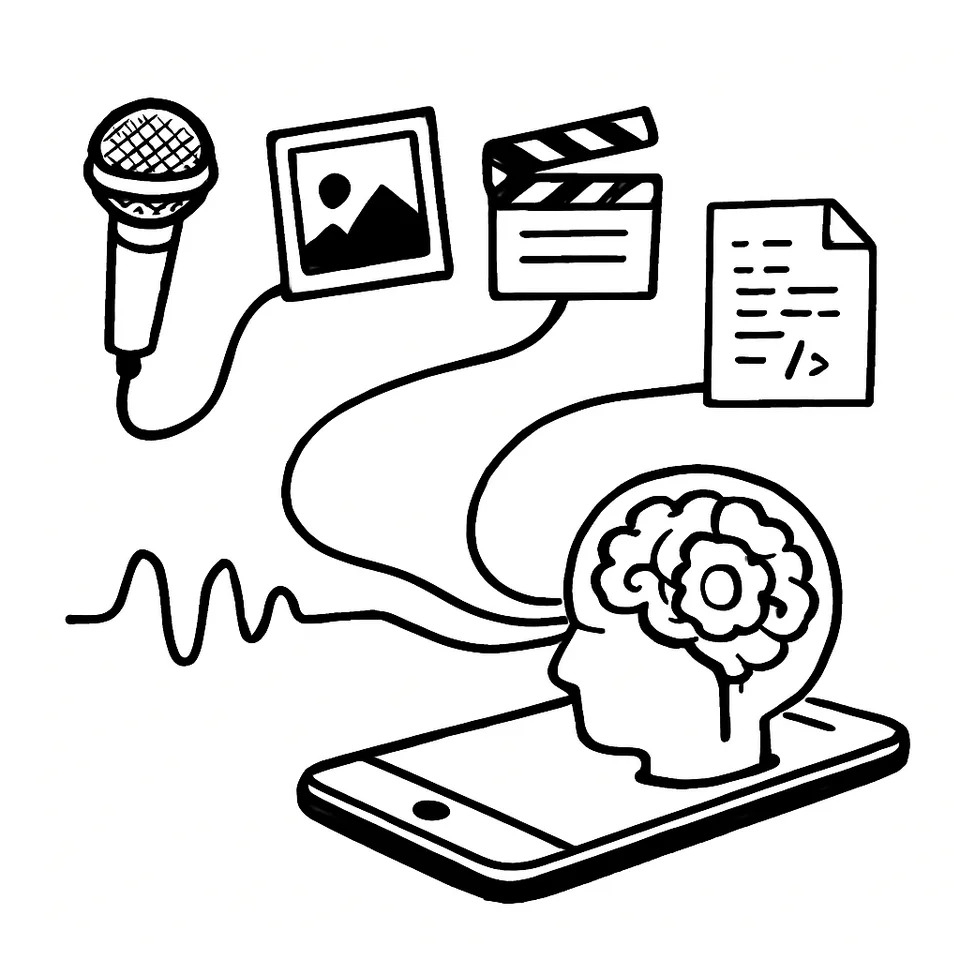
DeepMind presenta EmbeddingGemma 2: 740 milioni di parametri, spazio di embedding unico per testo, codice, immagini, video e audio, architettura Gemma 4 e licenza Apache 2.0. Il modello nasce per inferenza on‑device1.
EmbeddingGemma 2 mappa contenuti eterogenei nello stesso spazio vettoriale. Esegue confronti tra forme diverse di input senza passaggi intermedi. DeepMind cita due esempi: cercare un clip video partendo da un memo vocale e scorrere ore di registrazioni audio con una query testuale. Tutto in un singolo modello nativamente multimodale1.
Deriva dalla stessa tecnologia di Gemini Embedding e punta al miglior rapporto qualità‑dimensione nella sua classe. DeepMind lo definisce “best‑in‑class per la sua taglia”, con risultati di vertice tra gli embedders multimodali sotto il miliardo di parametri su suite come MTEB. L’obiettivo: prestazioni elevate in formato compatto, adatto a hardware consumer1.
La seconda versione estende la portata della prima, nata come opzione leggera per embedding testuali. L’uso tipico: organizzare, cercare e collegare informazioni direttamente su dispositivi consumer. La risposta degli sviluppatori, secondo DeepMind: oltre 20 milioni di download e impieghi in strumenti di ricerca on‑device e pipeline RAG orientate alla privacy1.
Con EmbeddingGemma 2 la multimodalità diventa ampia: testo, codice, immagini, video e audio confluiscono nello stesso spazio di rappresentazione. Un unico encoder gestisce query e contenuti anche quando appartengono a modalità diverse, come voce e video o testo e audio. La dimensione resta a 740 milioni di parametri, profilo che la società indica come ottimale per l’esecuzione su dispositivo1.
Licenza: Apache 2.0, che DeepMind qualifica come “commercialmente permissiva”. L’architettura è Gemma 4, in continuità con la famiglia tecnologica a cui si collegano i Gemini Embedding. Questa coerenza riduce la distanza tra la precedente offerta focalizzata sul testo e la nuova estensione multimodale1.
Sul fronte delle metriche, DeepMind richiama i benchmark: risultati di vertice nella fascia sotto il miliardo di parametri su suite come MTEB. È il metro scelto per posizionare il modello rispetto ai pari, con enfasi sulla dimensione contenuta e sull’operatività su hardware consumer1.
Per chi sviluppa, un singolo spazio di embedding per tutte le modalità può semplificare l’integrazione: meno componenti da orchestrare e allineare. In scenari locali, questo approccio riduce i passaggi tra moduli e può tagliare la latenza end‑to‑end1.
Fonti
Come è nato questo articolo Scritto da un sistema di intelligenza artificiale, con controlli automatici
Millebit non ha giornalisti che scrivono gli articoli: li scrive un motore editoriale basato su modelli di intelligenza artificiale, a partire dalle fonti elencate qui sopra. Prima di uscire, ogni testo passa questi controlli:
- Fedeltà alle fonti. Un secondo passaggio toglie ogni affermazione che le fonti non sostengono.
- Anti-cliché. Un filtro scarta frasi fatte, enfasi e tic della prosa artificiale.
- Giudizio editoriale. Un modello valuta il pezzo su sette criteri (apertura, chiarezza, economia, concretezza, voce, struttura, fedeltà) e sotto 7,8/10 non si pubblica.
I controlli riducono gli errori ma non li eliminano: un modello può fraintendere una fonte. Per le decisioni importanti, risali alla fonte originale. Se trovi un errore, segnalacelo.
Per vedere Millebit nelle notizie principali di Google, aggiungilo alle tue fonti preferite. Oppure segui l’edizione di oggi, il feed RSS o La Sintesi.